Am 10. November 2026 fand die Stape Relay 2026 statt, die jährliche Konferenz von Stape rund um Server-Side Tracking. Ich habe die Sessions live verfolgt und fasse die wichtigsten Inhalte hier auf Deutsch zusammen, mit Folien, Antworten aus den Q&A-Runden und meiner Einordnung. Der Beitrag ist im Laufe des Tages gewachsen: Oben finden Sie die Agenda, danach die Sessions in der Reihenfolge, in der ich sie verfolgt habe.
Worum es bei der Stape Relay geht
Stape gehört zu den bekanntesten Plattformen für Server-Side Tracking. Das Unternehmen betreibt die Infrastruktur für serverseitige Google-Tag-Manager-Container (sGTM) und liefert dazu Tags, Gateways, Plugins und sogenannte Power-Ups. Damit lassen sich Tracking-Daten zuverlässiger erfassen, anreichern und weitergeben, auch wenn Browser, Adblocker und Cookie-Restriktionen das klassische clientseitige Tracking immer stärker einschränken. Warum das wichtig ist, erkläre ich ausführlich im Beitrag zum Server Side Tracking.
Mit der Stape Relay versammelt Stape einmal im Jahr die Community rund um Server-Side Tagging. Der Anspruch: Einstieg für Neulinge und Pflichtupdate für Power-User. 2026 hat die Konferenz einen besonderen Anlass, denn Stape wird fünf Jahre alt.
Die Agenda der Stape Relay 2026 im Überblick
Der Tag startet auf der Main Stage. Ab 11 Uhr teilt sich das Programm in zwei parallele Tracks: einen für Strategie & Architektur und einen für Produkt & Implementierung. Alle Zeiten in MEZ.
Vormittag: Keynote und Produkt-Neuheiten
| Uhrzeit | Session | Speaker |
|---|---|---|
| 09:30 | Begrüßung und Kickoff | Dan Murovtsev, Marcin Pluskota (Stape) |
| 09:40 | Keynote: „More power. Same core.“ | Ira Holubovska (COO) und Denis Golubovskyi (CEO), Gründer von Stape |
| 09:55 | Product Showcase: Highlights 2026 und kommende Releases | Dan Murovtsev, Denis Golubovskyi |
Unter dem Motto „More power. Same core.“ geben die beiden Stape-Gründer einen Ausblick, wohin sich die Plattform entwickelt. Angekündigt sind auch einige noch geheime Neuigkeiten. Im anschließenden Product Showcase geht es um die wichtigsten Produkt-Updates aus 2026 und eine Vorschau auf neue Features und Tools im Stape-Ökosystem.
Track-Sessions am Vormittag
| Uhrzeit | Track 1: Strategie & Architektur | Track 2: Produkt & Implementierung |
|---|---|---|
| 11:00 | Die nächste Generation des GTM: Architektur-Änderungen rund um die vereinheitlichte Google-Tag-Engine (Karolina Wrzask, Google) | sGTM und Data Enrichment: Events mit Produktmargen und CRM-Daten anreichern, für stärkere Signale an GA4, Google Ads und Meta (Julius Fedorovicius, Analytics Mania) |
| 11:30 | Lessons Learned aus vielen Server-Side-Projekten: 10 typische Fehler und ihre wirtschaftlichen Folgen (Juliana Jackson, François de Broissia, Jellyfish) | Bidding auf vorhergesagten Umsatz: Lead-Gen-Setup mit sGTM, Firestore, BigQuery und Stape (Daniel Perry-Reed) |
| 12:00 | Case Study Marktplaats: 86 Millionen Web-Events pro Tag mit Managed sGTM, inklusive Buy-vs.-Build-Entscheidung und Data Governance (Anastasia Shcherbakova, Serge Shkvarnytskyi) | Generalprobe auf der Live-Site: neue TMS-, sGTM- und Google-Tag-Gateway-Setups testen, ohne die Produktion anzufassen (Doug Hall) |
Mittag: Jubiläum und GTM-Template-Roadmap
| Uhrzeit | Session | Speaker |
|---|---|---|
| 12:30 | 5 Jahre Stape: Halbzeit-Show | Matteo Zambon, Dan Murovtsev, Marcin Pluskota |
| 13:00 | GTM Templates: Next Generation, die Roadmap | Simo Ahava, Giovani Ortolani Barbosa, Dan Murovtsev |
| 13:30 | Von Pageviews zu Pipelines: wie sich Analytics über die Community entwickelt hat | Caroline Vidal, Peter O’Neill, Bhavik Patel |
Für viele in der Szene ist das der heimliche Höhepunkt: Simo Ahava, einer der bekanntesten Köpfe der Google-Tag-Manager-Welt, stellt mit Stape eine gemeinsame Roadmap vor. Bestehende GTM-Templates sollen überarbeitet und neue entwickelt werden, auf Basis von Feedback aus der Community.
Track-Sessions am Nachmittag
| Uhrzeit | Track 1: Strategie & Architektur | Track 2: Produkt & Implementierung |
|---|---|---|
| 14:00 | Server-Side Tracking 2027: Entscheidungshilfe zwischen Client-Side, Server-Side, Subdomain, Same-Origin und Google Tag Gateway (Jenny Bachmann, mohrstade) | +20 % mehr Google-Ads-Conversions mit den Stape-Power-Ups Custom Loader, Click ID Restorer und Cookie Keeper (Lars Friis) |
| 14:30 | Warum GA4 nie zum CRM passt: sechs typische Fehler im Formular-Tracking und ihre Lösung mit dataLayer und sGTM (Josh Silverbauer) | Case Study Champion Europe: +35 % ROAS auf Shopify Plus mit Server-Side, Consent Mode v2 und GA4 (Matteo Zambon) |
| 15:00 | Mehr aus der Meta Conversions API holen: Pixel und CAPI im Zusammenspiel, First-Party-Daten und Event-Qualität (Katie Glass, Meta) | KI in GTM, GA4 und Server-Side: die MCP-Server und der AI Assistant von Stape (Manisha Mistry) |
Abschluss
Um 15:30 Uhr folgen auf der Main Stage die letzten Ankündigungen und eine Zusammenfassung des Tages. Um 16:00 Uhr endet die Stape Relay 2026.
Product Showcase: Die Stape-Highlights 2026 und was als Nächstes kommt
Im Product Showcase haben Product Manager Dan Murovtsev und CEO Denis Golubovskyi gezeigt, welche Produkte hinter der Stape-Strategie stehen. Die Session war entlang von drei Problemen aufgebaut, die Stape nach eigener Aussage bis heute fast täglich von Kunden hört:
- Unvollständige Daten: Browser-Restriktionen und Tracking-Schutz reißen Lücken in die Datenerfassung.
- Falsche Signale: Werbebudgets optimieren auf die falschen oder auf zu wenige Signale.
- Abhängigkeit von Entwicklern: Für jede Änderung braucht es technisches Know-how oder Zugänge, die fehlen.
Danach folgten die Enterprise-Ausrichtung von Stape und zwei Produkt-Reveals.
Problem 1: Unvollständige Daten
Für die Datenlücken hat Stape vier Bausteine gezeigt, jeweils live im Stape-Dashboard.
Custom Loader: Werbeblocker blockieren häufig schon das GTM-Skript selbst, weil es von der Drittanbieter-Domain googletagmanager.com geladen wird. Der Custom Loader ist ein Power-Up im Stape-Container. Er liefert den Web-Container über eine eigene Subdomain oder ein Same-Origin-Setup aus und verschleiert ihn gegenüber Tracking-Schutz. Dafür erzeugt Stape ein neues Snippet, das das bisherige GTM-Snippet ersetzt. In den CMS-Apps, etwa für Shopify, reichen ein paar Eingabefelder. Zusätzlich gibt es die Option „Enhanced Ad Blocker Protection“: Sie schützt auch die Requests, die der GTM danach verschickt, etwa die /collect-Requests von GA4 und die /data-Requests des Data Tags.
Cookie Keeper: Safari (ITP), Firefox (ETP) und Brave begrenzen die Laufzeit von Cookies, oft auf sieben Tage. Cookie Keeper verlängert sie. Das Power-Up lässt sich direkt zusammen mit dem Custom Loader einrichten. In einer Liste wählen Sie, welche Cookies verlängert werden sollen, von Stape-eigenen Cookies über Google Analytics und Google Ads bis zu den gängigen Werbeplattformen. Eigene Cookies lassen sich ergänzen.
Request Analytics: Diese Auswertung gibt es in jedem Stape-Container. Sie zeigt, was Server-Side Tracking tatsächlich zurückholt: die Gesamtzahl der Requests und den Anteil, der aus Umgebungen mit Werbeblockern oder mit Tracking-Schutz stammt. Aufgeschlüsselt wird nach Client (GA4, Data Tag, weitere Skripte) und Event, nach Browser, nach Bot-Traffic und für GA4 auch nach Consent-Status. Damit sehen Sie, wie viele Events mit Einwilligung, ohne Einwilligung oder ganz ohne Consent-Signal ankommen.
Logs und Monitoring: Eingehende Requests protokolliert Stape automatisch. API-Keys, personenbezogene Daten und Cookies werden dabei laut Stape entfernt. Ausgehende Requests, etwa an Meta, lassen sich zusätzlich aktivieren. Dann sehen Sie, was tatsächlich gesendet wurde und welche Antwort die Plattform zurückgegeben hat. Auf den Logs baut das Monitoring auf: Es zeigt Erfolgsquoten der ausgehenden Requests und verschickt per E-Mail Alarme bei selbst definierten Bedingungen.
Problem 2: Falsche Signale für das Werbebudget
„Mehr Daten zu sammeln ist wichtig, die richtigen Daten zu senden ist wichtiger“, so Denis Golubovskyi sinngemäß. Werbeplattformen sehen Klicks und Umsatz, aber nicht Gewinn, Lead-Qualität oder Offline-Verkäufe. Events aus dem eigenen Backend fehlt zudem oft der Bezug zur ursprünglichen Conversion auf der Website. Dafür gibt es drei Produkte:
Data Store (früher Stape Store): eine NoSQL-Datenbank, die im Stape-Netz möglichst nah am Server-Container läuft und deshalb kurze Antwortzeiten hat. Wer Firestore kennt, findet viele Prinzipien wieder. Über Writer-Tag und Lookup-Variablen im sGTM lässt sich darin speichern und nachschlagen, etwa um Offline-Events mit Online-Events zu verbinden oder Daten zwischen zwei Schritten im Funnel weiterzugeben, die im Frontend nicht verfügbar sind. Data Store gleicht damit aus, dass der Google Tag Manager selbst keinen dauerhaften Speicher hat.
POAS Data Feed: POAS steht für Profit on Ad Spend. Das Power-Up ist eine fertig eingerichtete Data-Store-Sammlung für Produktdaten. Sie wird per CSV oder URL aus dem Produktfeed befüllt, auf Wunsch täglich oder wöchentlich. Eine Variable nimmt das Items-Array eines Events, schlägt die Margen aller Produkte nach und gibt den Gewinn statt des Umsatzes zurück. So kann das Bidding auf Gewinn statt auf Umsatz optimieren.
Enricher: Dan Murovtsev beschreibt ihn als „leichte CDP“, also eine Customer Data Platform direkt im Tracking. Der Enricher speichert Nutzerdaten und ergänzt sie bei späteren Requests, wenn sie dort fehlen. Dafür gleicht er mehrere Kennungen ab, etwa die GA4-Cookies. Gespeichert wird in Cookies, im Data Store oder in beidem. Beide Wege lassen sich an die Marketing-Einwilligung koppeln, auf Basis von Consent Mode v2 bei GA4 und dem Consent-Objekt des Data Tags. Im automatischen Modus landen die Daten genau dort, wo die Tags im Server-Container sie erwarten, ohne manuelles Mapping. Im halbautomatischen Modus entscheiden Sie selbst, welcher Tag welche Daten bekommt.
Meine Einordnung: POAS Data Feed und Enricher sind die beiden Bausteine mit dem größten direkten Effekt auf die Kampagnenleistung. Wer auf Gewinn statt Umsatz bietet, verschiebt Budget zu den Produkten, die wirklich Geld verdienen. Der Enricher erhöht die Match-Raten bei Meta und Google, weil spätere Events die Daten früherer Events mitbringen. Beides funktioniert aber nur so gut wie die Daten, die hineinfließen: Margen müssen gepflegt sein, und die Einwilligung muss sauber an den Enricher gekoppelt werden.
Problem 3: Abhängigkeit von Entwicklern
Stapes erklärtes Ziel ist es, den Zugang zu Server-Side Tracking zu „demokratisieren“. Der Umstieg bedeutet heute oft einen Neuanfang: Das Web-Setup muss angepasst, ein Server-Container aufgebaut und für jedes Ziel ein Template gefunden werden. Dazu kommen die Eigenheiten der Shopsysteme, Offline-Daten, die selten angebunden sind, sowie Audits und Debugging, die viele Stunden kosten. Darauf antwortet Stape mit fünf Bausteinen.
Setup Wizard 2.0: Vom Client-Side-Setup zum Server-Side-Container
Der Setup Wizard erzeugt Schritt für Schritt fertige Container-Vorlagen für Web und Server, mit Tags, gemappten Daten und eingerichteten Abläufen. Bisher entstanden diese Vorlagen neu, etwa passend für Shopify oder WordPress. Seit Sonntag, dem 8. November 2026, gibt es einen zusätzlichen Migrations-Flow: Der Wizard scannt den bestehenden Web-Container und baut daraus das serverseitige Gegenstück. Das geschieht KI-gestützt, mit Leitplanken, die Stape vorgibt.
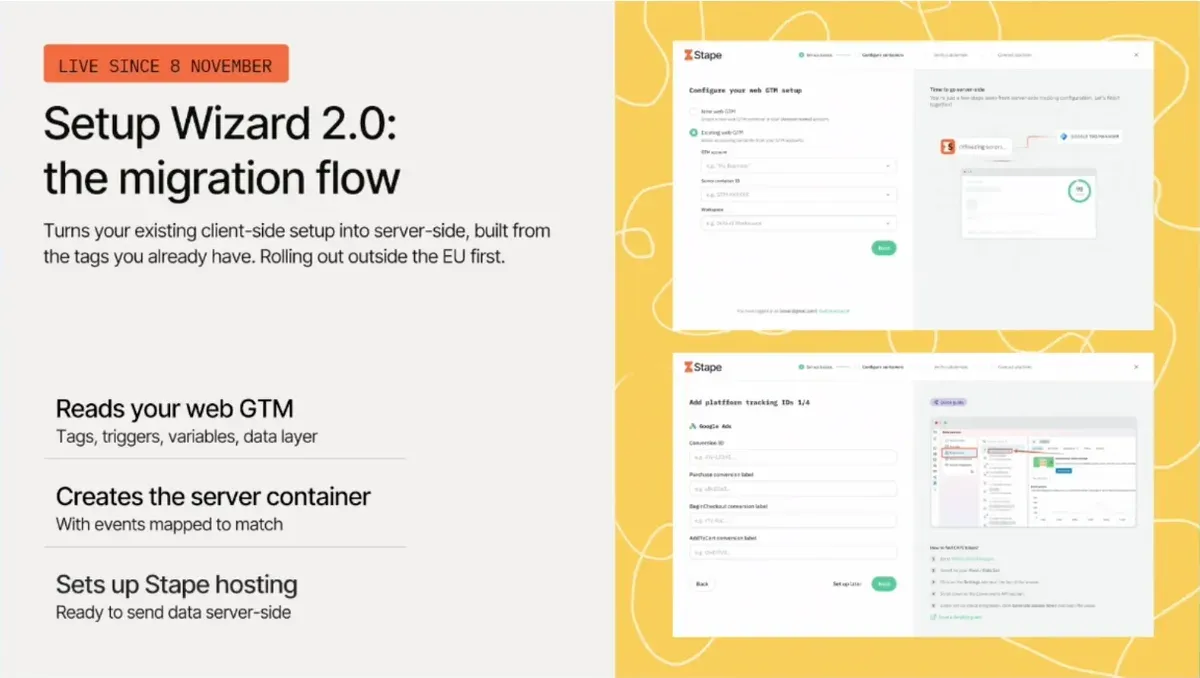
Folie aus dem Product Showcase der Stape Relay 2026 (Quelle: Stape)
Der Migrations-Flow arbeitet in drei Schritten:
- Web-GTM auslesen: Er liest den bestehenden Web-Container aus, also Tags, Trigger, Variablen und den dataLayer.
- Server-Container anlegen: Daraus erstellt er einen Server-Container, in dem die Events passend zum Web-Container gemappt sind.
- Stape-Hosting einrichten: Zum Schluss richtet er das Hosting bei Stape ein, sodass der Container sofort Daten serverseitig senden kann.
In der Oberfläche wählen Sie zuerst, ob Sie mit einem neuen oder einem bestehenden Web-Container starten, und geben GTM-Konto, Container und Workspace an. Danach hinterlegen Sie die Tracking-IDs der Plattformen, etwa die Conversion-ID und die Conversion-Labels für Google Ads.
Verfügbar ist der Flow zunächst nur für Kunden auf Stape Global. Für die EU rechnet Dan Murovtsev mit etwa einem Monat, weil die Region stärker reguliert ist.
Meine Einordnung: Für viele Unternehmen ist die Migration der größte Aufwand beim Umstieg auf Server-Side Tracking. Ein Assistent, der den bestehenden Container als Grundlage nimmt, senkt diese Hürde deutlich. Ein automatisch erzeugter Container übernimmt aber auch die Schwächen des bestehenden Setups. Consent Mode, Deduplizierung zwischen Browser- und Server-Events sowie die Datenqualität sollten Sie nach der Migration gezielt prüfen.
GTM-Templates, CMS- und CRM-Apps
GTM-Templates: Stape ist nach eigener Aussage der größte Beitragende zur Community Template Gallery des GTM, mit mehr als 150 Templates. Um 13 Uhr stellen Simo Ahava und Stape dazu eine eigene Roadmap vor.
CMS-Apps: Am Beispiel Shopify zeigte Dan Murovtsev, was die Apps leisten. Vergleichbare Apps gibt es unter anderem für WooCommerce, BigCommerce, PrestaShop, Shopware, Wix, Magento und Drupal. Die Apps erledigen drei Dinge ohne Eingriff in den Code oder das Theme:
- Sie binden den GTM-Container ein, auf Wunsch über eine eigene Domain und den Custom Loader.
- Sie liefern einen E-Commerce-dataLayer im GA4-Schema, von der Produktansicht über den Warenkorb bis zum Kauf.
- Sie senden Webhooks für Käufe und Erstattungen an den Server-Container. Der Kauf-Webhook wird häufig genutzt, um den Umsatz vollständig an die Plattformen zu melden, auch wenn der Browser-Funnel abbricht.
CRM-Apps: Gezeigt wurde HighLevel, abgedeckt sind unter anderem auch HubSpot und Salesforce. Erreicht ein Datensatz eine bestimmte Stufe in der Pipeline, schickt die App einen Webhook an den Server-Container, der ihn als Offline-Conversion an die Plattformen weitergibt. Die Payload wird ähnlich wie ein Tag im GTM konfiguriert. Für die Anbindung reicht der Stape-API-Key. Außerdem lassen sich aus dem CRM direkt Custom Audiences bei Meta und Customer-Match-Listen bei Google befüllen oder bereinigen, Letzteres über die Data Manager API.
KI: AI Assistant und vier MCP-Server
Im Stape-Konto gibt es oben im Menü einen AI Assistant. Der Chat kennt die Stape-API, das Stape-Blog und die Dokumentation. Er kann also etwa die eigenen Container auflisten oder Fragen zur Migration beantworten. Über „Connections“ lassen sich nach einer Anmeldung bei Google zusätzlich Google Tag Manager, GA4 und Google Ads anbinden.
Die Grundlage bilden vier kostenlose MCP-Server (Model Context Protocol), die Stape auch einzeln anbietet: für die Stape-API, für GTM-Container, für GA4-Daten und für Google Ads. In der Demo wurde der GTM-MCP-Server als Custom Connector in Claude eingebunden. Die URLs und Anleitungen für andere KI-Anwendungen stehen im Stape-Helpdesk und auf GitHub.
Stape Enterprise: Server-Side Tracking für Konzernanforderungen
Stape hat vor fünf Jahren als einfaches Hosting für den Server-Side GTM begonnen und seitdem schrittweise Funktionen für große Unternehmen ergänzt. Heute sei Stape „enterprise-ready“, so Denis Golubovskyi. Ein eigenes Produkt ist das nicht, sondern eine Ausrichtung des bestehenden Angebots. Das Versprechen: dasselbe Server-Side-Tracking wie bisher, ergänzt um das, was Security, Datenschutz, Einkauf und Data-Team brauchen, um einer Einführung zuzustimmen.
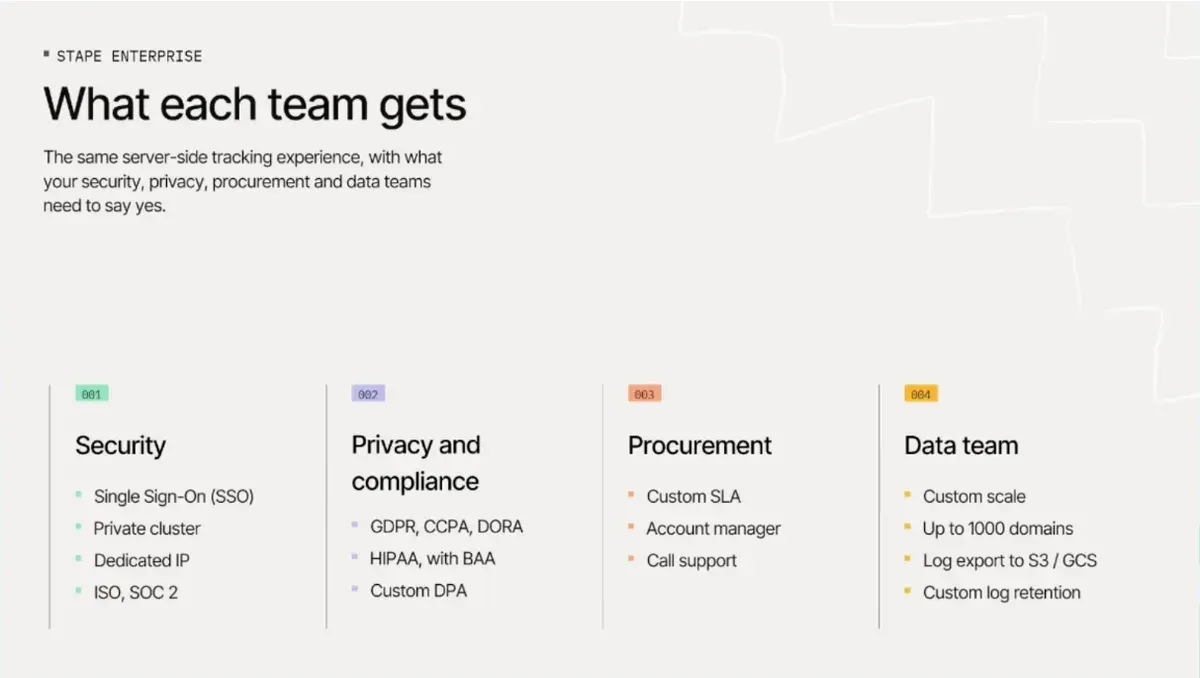
Folie aus dem Product Showcase der Stape Relay 2026 (Quelle: Stape)
| Team | Was Stape Enterprise mitbringt |
|---|---|
| Security | Single Sign-On (SSO), Private Cluster, dedizierte IP-Adresse, ISO und SOC 2 |
| Datenschutz und Compliance | DSGVO, CCPA und DORA, HIPAA mit Business Associate Agreement (BAA), individueller Auftragsverarbeitungsvertrag (DPA) |
| Einkauf | Individuelles SLA, fester Account Manager, Support per Telefon, auf Wunsch Registrierung in Lieferantenportalen |
| Data-Team | Individuelle Skalierung, bis zu 1.000 Domains, Log-Export nach Amazon S3 oder Google Cloud Storage, individuelle Aufbewahrungsdauer für Logs |
Bestandskunden wenden sich an ihren Account Manager, neue Interessenten an den Vertrieb. Stape betonte zugleich, dass das Angebot weiter für Unternehmen jeder Größe gedacht ist.
Meine Einordnung: In größeren Unternehmen scheitert Server-Side Tracking selten an der Technik. Meistens hängt es an Informationssicherheit, Datenschutz und Einkauf. Mit SSO, eigenem Cluster, individuellem DPA und SLA beantwortet Stape genau die Fragen, die in diesen Freigaberunden gestellt werden. Interessant für regulierte Branchen ist der Hinweis auf DORA, die EU-Verordnung zur digitalen Betriebsstabilität im Finanzsektor. Der Log-Export in eigene Cloud-Speicher hilft bei Audits und eigenen Auswertungen. Welche Zertifizierungen und Vertragsdetails konkret gelten, sollten Sie vor einer Entscheidung im Einzelnen bei Stape anfragen.
Die Reveals: Was bei Stape als Nächstes kommt
Zum Schluss gab es die zwei angekündigten Produkt-Reveals, nach Stapes eigener Aussage „in aufsteigender Reihenfolge, das Beste zum Schluss“.
Enricher 2.0: Vom Power-Up zur Kernfunktion
Der Enricher wird ausgebaut und wandert aus den Power-Ups in einen eigenen Reiter, gleichrangig mit Data Store und Request Analytics. Stape will die Funktion damit schrittweise in Richtung CDP entwickeln. Erscheinen soll der Enricher 2.0 bis Ende 2026. In der Halbzeit-Show wurde Stape konkreter: Das Ziel ist der 24. Dezember.
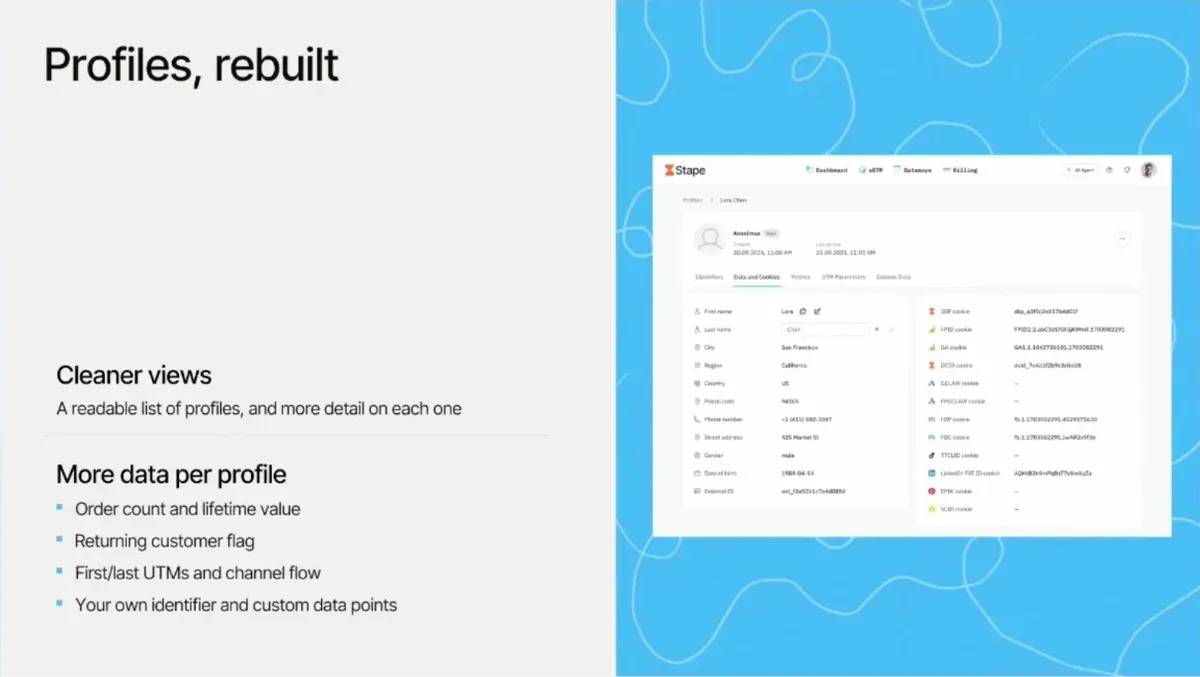
Folie aus dem Product Showcase der Stape Relay 2026 (Quelle: Stape)
Was sich ändert:
- Neue Profilansicht: Bisher sahen Profile aus wie Sammlungen und Dokumente im Data Store. Künftig gibt es eine lesbare Liste aller Profile und mehr Details im einzelnen Profil.
- Mehr Daten pro Profil, ohne Zusatzaufwand: Anzahl der Bestellungen, Customer Lifetime Value, neue oder wiederkehrende Kunden sowie erste und letzte UTM-Parameter mit dem gesamten Kanalverlauf
- Eigene Kennungen: Bisher gleicht der Enricher Nutzer über sechs Kennungen ab. Künftig können Unternehmen eine eigene, verlässliche Kennung in diese Hierarchie einhängen, aus einem Cookie oder aus der Payload eines Requests.
- Import und Export: Profile lassen sich per CSV vorbefüllen, etwa mit bestehenden Kundenlisten, sofern die Einwilligung dafür vorliegt. Die Ergebnisse lassen sich exportieren, etwa für Auswertungen in BigQuery.
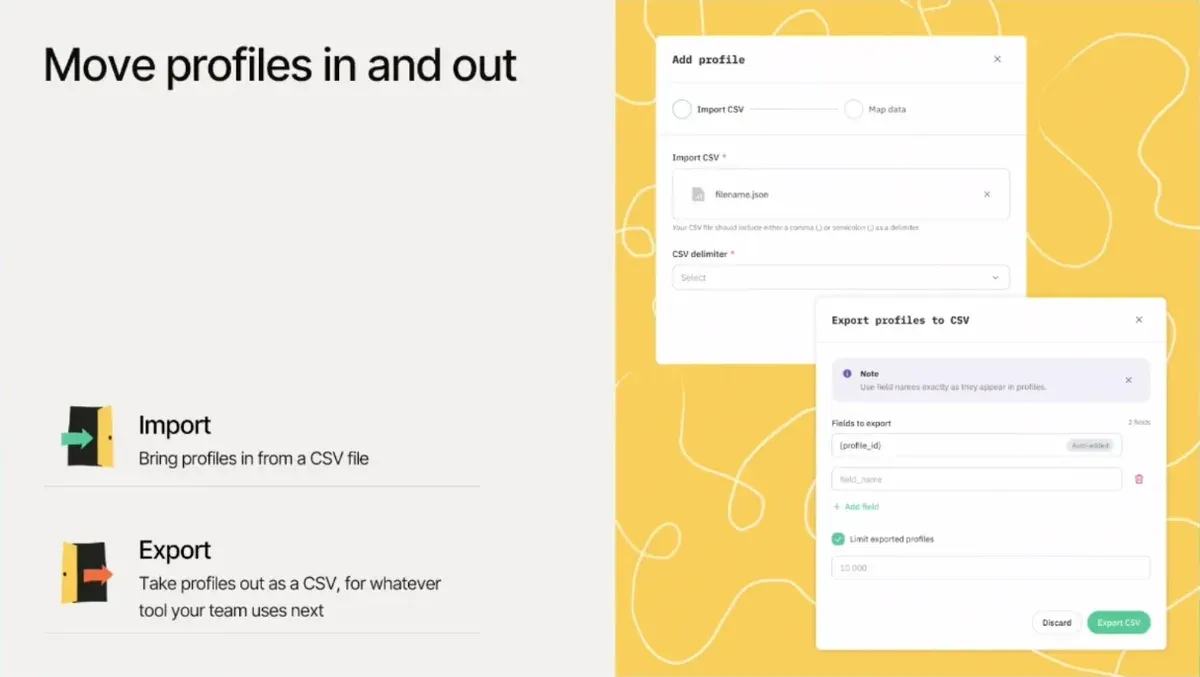
Folie aus dem Product Showcase der Stape Relay 2026 (Quelle: Stape)
Meine Einordnung: Lifetime Value, Wiederkäufer-Status und Kanalverlauf direkt am Server sind genau die Signale, die wertbasiertes Bidding in Google Ads und Meta braucht. Wer bisher dafür eine eigene Datenbank oder Firestore angebunden hat, bekommt das künftig direkt in Stape. Gleichzeitig enthalten Profile personenbezogene Daten wie Name, Telefonnummer oder Adresse. Für Unternehmen in der EU gehören deshalb Rechtsgrundlage, Einwilligung, Speicherdauer und der Auftragsverarbeitungsvertrag vor dem Einsatz auf den Prüfstand. Das gilt besonders für den CSV-Import von Kundendaten.
Aus dem Q&A zum Enricher:
- External ID: Eine
external_idim Request behandelt der Enricher nur als Datenpunkt, nicht als Kennung für den Abgleich. Stape sieht sie in der Praxis zu oft falsch befüllt. Wer eine verlässliche eigene Kennung hat, kann sie im Enricher 2.0 als eigene Kennung festlegen, aus einem Cookie oder einem Parameter der Payload. Sie steht dann an erster Stelle beim Abgleich. - Request-Verbrauch: Enricher und Cookie Keeper verbrauchen Requests aus dem Abo. Cookie Keeper kostet einen Request pro Seitenaufruf. Der Enricher im Cookie-Modus, der mit einem verschlüsselten Cookie statt dem Data Store arbeitet, verursacht keine zusätzlichen Requests. Er ist weniger leistungsfähig als der Data-Store-Modus, verbessert die Match-Raten aber trotzdem.
- Events ausschließen: Im Enricher 2.0 lassen sich Events vom Anreichern ausnehmen, etwa Scrolls oder Klicks, damit sie keine Requests verbrauchen.
Stape bringt eine eigene Consent Management Platform
Die größte Ankündigung: Stape hat eine eigene Consent Management Platform (CMP) gebaut, unter dem Motto „Smoother privacy, less friction“. Laut Denis Golubovskyi ist sie fertig und wurde nur für diesen Tag zurückgehalten. Live geht sie laut Stape am Sonntag, 15. November 2026, ab Montag können Kunden sie nutzen. Eine Lizenzgebühr fällt nicht an: Die CMP ist ab dem Pro-Tarif, dem ersten kostenpflichtigen Stape-Abo, enthalten. Sie verbraucht allerdings Requests aus dem Kontingent des Abos (Details unten im Q&A).
Folie aus dem Product Showcase der Stape Relay 2026 (Quelle: Stape)
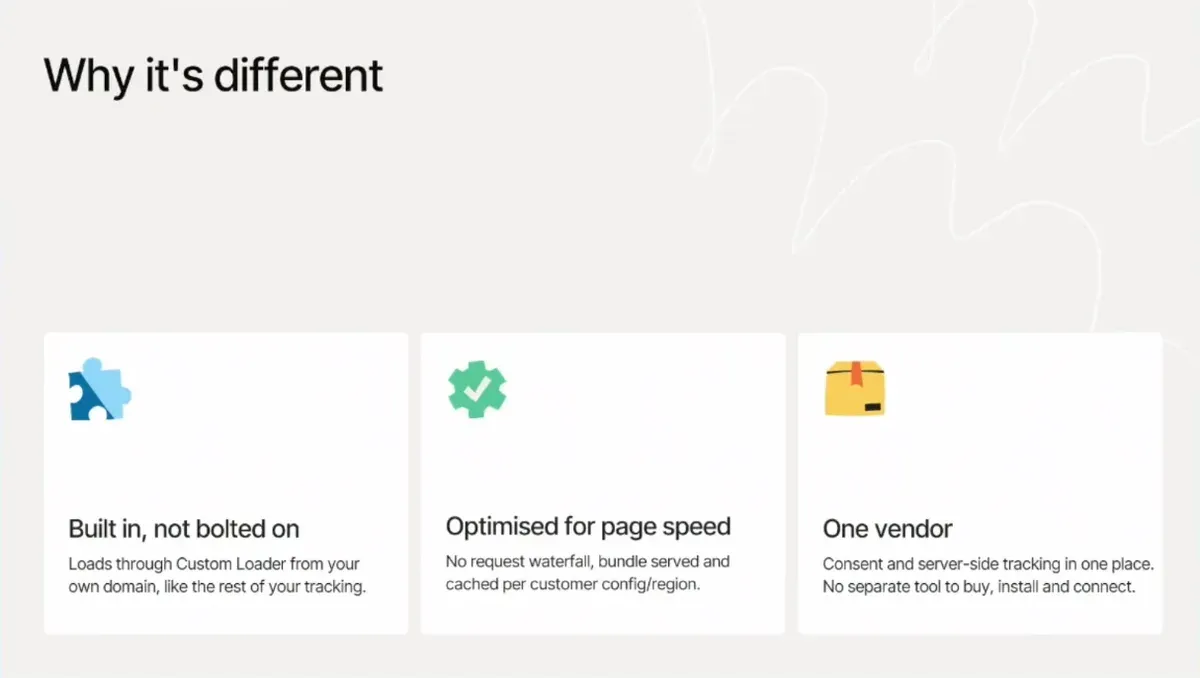
Warum eine eigene CMP? Stape habe geprüft, wie sich die gewünschte Integration mit bestehenden CMPs erreichen lässt, und sich dann für eine eigene Lösung entschieden. Was sie laut Stape unterscheidet:
- Integriert statt aufgesetzt: Sie lädt über den Custom Loader von der eigenen Domain, genau wie das übrige Tracking.
- Optimiert für die Ladezeit: Es gibt keine Kaskade nacheinander geladener Requests. Das Bundle wird je Kundenkonfiguration und Region ausgeliefert und gecacht.
- Ein Anbieter: Consent und Server-Side Tracking kommen aus einer Hand. Es muss kein separates Tool gekauft, installiert und angebunden werden.
Zum Funktionsumfang gehören ein eigenes Banner im eigenen Design, eine Seite zum Ändern oder Widerrufen der Einwilligung und Regeln je Land, darunter DSGVO, CCPA/CPRA (Kalifornien), VCDPA (Virginia), LGPD (Brasilien) und POPIA (Südafrika). Unterstützt werden die gängigen Standards, darunter Google Consent Mode und die Consent-Signale von Microsoft. Die CMP ist nach Aussage von Stape bereits für das IAB TCF zertifiziert, arbeitet eng mit Shopify zusammen und ist mit dem Enricher verzahnt. Geplant ist außerdem, einen Widerruf über die Stape-Apps automatisch an CRM-Systeme wie HubSpot weiterzugeben. „Eine vollständige CMP, nicht nur ein Cookie-Banner“, fasst Denis Golubovskyi zusammen.
Live-Demo: So sieht die Stape-CMP aus
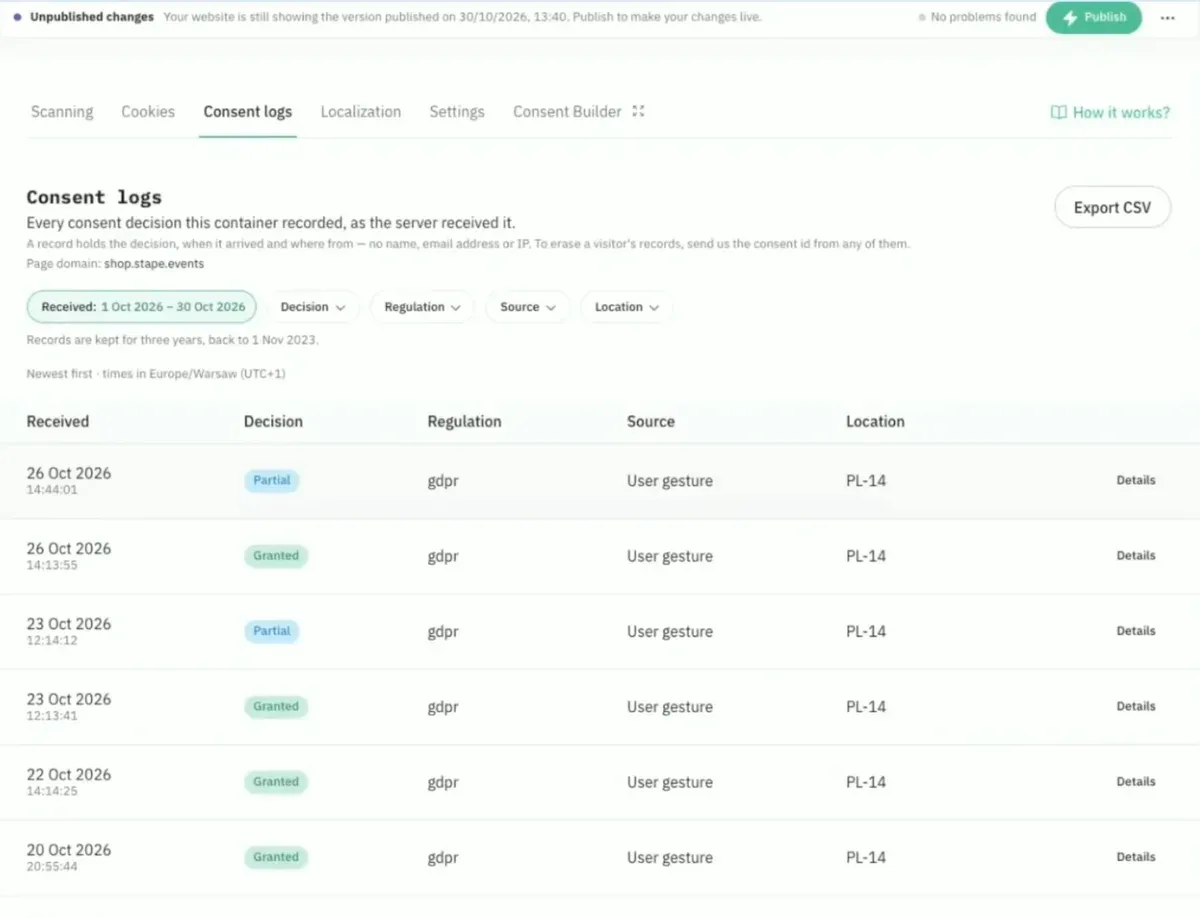
Gezeigt wurde die CMP in der Staging-Umgebung von Stape. Einzelne Details können sich bis zum Start also noch ändern. Die CMP erscheint im Stape-Dashboard als eigener Reiter direkt im Container und ist in sechs Bereiche gegliedert: Scanning, Cookies, Consent Logs, Localization, Settings und Consent Builder.
Scanning und Cookies: Ein Scanner findet die Cookies der Website und meldet Einträge, die noch nicht in der Cookie-Richtlinie stehen. Sie lassen sich mit wenigen Klicks übernehmen. Für bekannte Cookies wie _fbp, _fbc oder _ga bringt Stape ein eigenes Verzeichnis mit Anbieter, Datenschutzlink, Laufzeit und Beschreibung mit. Jeder Eintrag lässt sich bearbeiten und einem oder mehreren Zwecken zuordnen, etwa „Advertising measurement“ oder „Analytics“.
Consent Logs: Jede Einwilligungsentscheidung wird so protokolliert, wie sie am Server angekommen ist: Entscheidung, Zeitpunkt, die gesetzten Consent-Signale, Auslöser, Website sowie Land und Region. Name, E-Mail-Adresse oder IP-Adresse speichert das Protokoll laut Stape nicht. Die Einträge werden drei Jahre aufbewahrt, lassen sich filtern und als CSV exportieren. Für die Löschung der Einträge eines Besuchers reicht dessen Consent-ID.
Screenshot aus der Live-Demo der Stape Relay 2026 (Quelle: Stape)
Localization: Alle Texte des Banners lassen sich übersetzen, zum Beispiel ins Deutsche. Englisch ist Standard und dient als Rückfallsprache: Fehlt eine Übersetzung, etwa bei einer Cookie-Beschreibung, erscheint der englische Text.
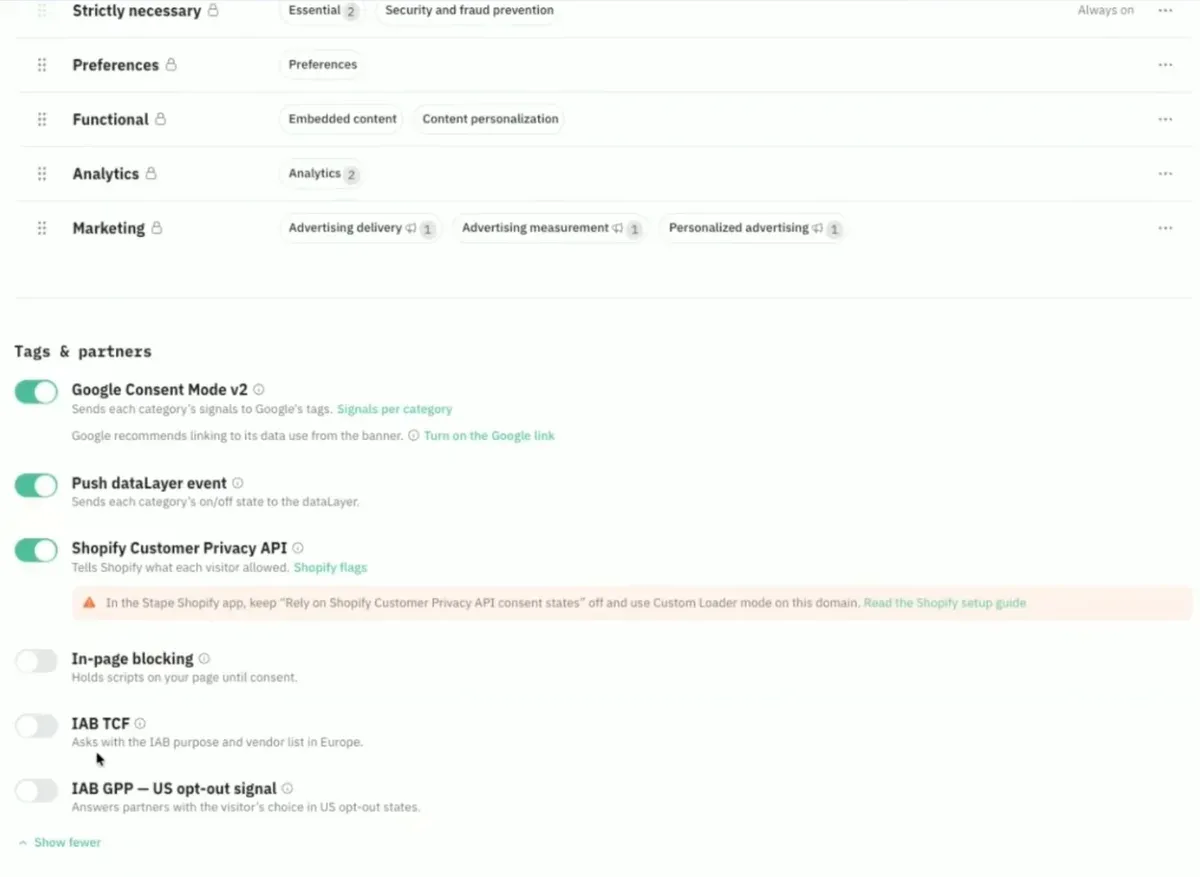
Settings: Hier legen Sie die Domain fest, Links zur Datenschutzerklärung und zum Datenschutzbeauftragten sowie den Umgang mit Bots: Banner überspringen, anzeigen oder Bots standardmäßig eine Einwilligung geben. Die Zwecke sind in fünf Kategorien gebündelt: Strictly necessary (immer aktiv), Preferences, Functional, Analytics und Marketing. Darunter schalten Sie die Anbindungen an andere Systeme einzeln ein:
- Google Consent Mode v2, mit den Signalen je Kategorie
- ein dataLayer-Event mit dem Status jeder Kategorie, etwa für Trigger im GTM
- die Shopify Customer Privacy API
- In-Page-Blocking, das Skripte von Drittanbietern bis zur Einwilligung zurückhält
- IAB TCF für den Einsatz mit der europäischen Anbieterliste des IAB
- IAB GPP als Opt-out-Signal für US-Bundesstaaten
Screenshot aus der Live-Demo der Stape Relay 2026 (Quelle: Stape)
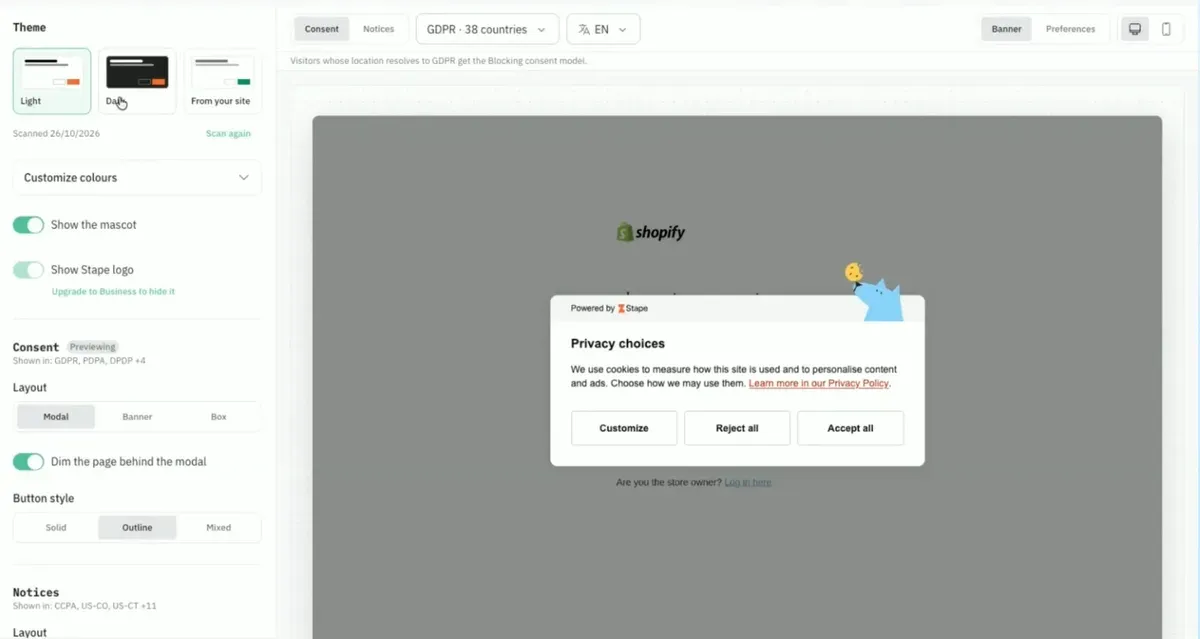
Consent Builder: Hier gestalten Sie das Banner. Das Theme ist hell, dunkel oder wird per Scan aus den Farben der eigenen Website übernommen. Es gibt zwei getrennte Modi: „Consent“ für Rechtsräume mit Einwilligungspflicht wie DSGVO, PDPA oder DPDP und „Notices“ für Hinweise im Opt-out-Modell, vor allem in Nordamerika. Als Layout stehen Modal, Banner oder Box zur Wahl, die Buttons gibt es gefüllt, umrandet oder gemischt, und der Seitenhintergrund lässt sich abdunkeln. Eine Vorschau zeigt Banner und Einstellungsebene auf Desktop und Mobilgerät. Das Maskottchen lässt sich abschalten, das Stape-Logo nur in höheren Tarifen. Änderungen gehen erst nach einem Klick auf „Publish“ live. Vorher weist die CMP auf Probleme hin, etwa auf fehlende Übersetzungen.
Screenshot aus der Live-Demo der Stape Relay 2026 (Quelle: Stape)
Im Frontend: Auf dem Demo-Shop erschien das Banner im DSGVO-Modus, weil der Präsentator in Polen saß. „Anpassen“, „Alle ablehnen“ und „Alle akzeptieren“ stehen gleichrangig auf der ersten Ebene. Auf der zweiten Ebene lassen sich die Kategorien einzeln wählen, jeweils mit der Liste der zugehörigen Cookies, Beschreibung und Link zum Anbieter. Nach der Entscheidung wurden im Hintergrund die Consent-Mode-Signale und die dataLayer-Events für die Trigger gesetzt.
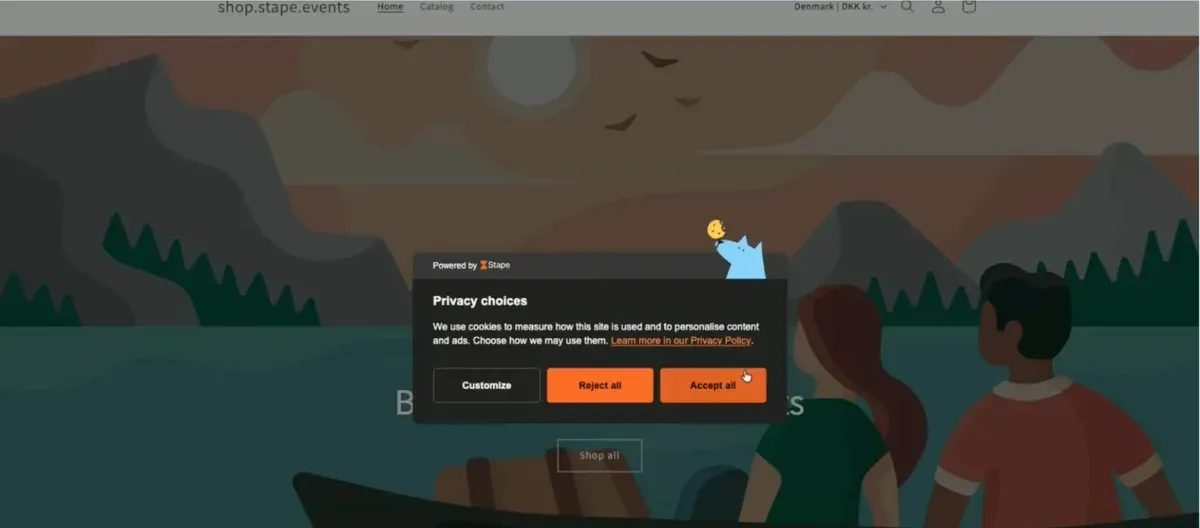
So sah das Banner im dunklen Theme auf dem Demo-Shop aus (Quelle: Stape)
Fragen und Antworten zur CMP
Im Q&A und im Live-Chat hat das Stape-Team weitere Details genannt:
- Kosten: Keine Lizenzgebühr, verfügbar ab dem Pro-Tarif. Die CMP verbraucht aber Requests aus dem Abo: einen für das Laden des Banner-Bundles bei jedem Seitenaufruf und einen weiteren für das Protokollieren jeder Entscheidung. Die Protokolle bewahrt Stape drei Jahre auf.
- Voraussetzung: Die CMP ist an den Server-Container gekoppelt, weil sie über den Custom Loader geladen wird. Wer nur die CMP nutzen will, kann technisch einen leeren Container anlegen und den Custom Loader allein für das Banner verwenden. Vorgesehen ist dieser Weg aber nicht.
- Plattformen: Die CMP funktioniert überall, wo sich das Snippet des Custom Loaders einbauen lässt, also auch auf individuell entwickelten Websites. An die CMS-Apps von Stape ist sie nicht gebunden.
- Cookie-Liste: Der Scanner befüllt die Cookie-Liste mit allem, was er auf der Website findet. Was er nicht findet, übernehmen Sie aus dem Verzeichnis mit Standard-Cookies oder legen es selbst an.
- Mehrere Rechtsräume: Mehrere Regelwerke wie DSGVO und CCPA werden standardmäßig parallel unterstützt. Cookies, Einwilligungen und Layout lassen sich je Sprache und Land anpassen.
- Mehrere Domains: Zum Start unterstützt die CMP eine Domain je Container. Mehrere Domains haben im Backlog höchste Priorität und sollen in einigen Wochen folgen.
- Button zum späteren Ändern: Ein schwebendes Widget gibt es zum Start nicht. Stattdessen öffnet ein JavaScript-Befehl oder ein HTML-Attribut die Einstellungen, etwa über einen Link im Footer. Ein Widget wird geprüft.
- Skripte außerhalb des Custom Loaders: Auch Skripte, die nicht über den Custom Loader laufen, etwa eine clientseitige Tracking-App in Shopify, kann die CMP blockieren.
- Wechsel von Cookiebot & Co.? Auf die Frage, ob man von Cookiebot zur Stape-CMP wechseln sollte, wenn man Stape ohnehin nutzt, antwortete das Stape-Team im Chat zurückhaltend: Tracking-Probleme liegen meist nicht an der CMP, sondern an der Konfiguration in Containern und Tags. Ein reiner CMP-Wechsel ändere daran nichts.
- Shopify: Mit der Shopify-App von Stape tauscht die CMP Signale mit der Consent-Verwaltung von Shopify aus. Dazu kommen dataLayer-Pushes und die Anbindung an das Consent-System des GTM.
Meine Einordnung: Das ist die Ankündigung mit der größten Tragweite für den deutschen Markt. Bisher brauchen Server-Side-Setups fast immer eine separate CMP wie Usercentrics, Cookiebot oder OneTrust, und genau an der Schnittstelle zwischen Banner, Consent Mode v2 und Server-Container entstehen die meisten Fehler. Eine CMP, die über denselben Loader von der eigenen Domain kommt, verringert Ladezeit und Abstimmungsaufwand. Die Demo beantwortet einige Fragen, die ich vorab hatte: Ein „Alle ablehnen“ steht gleichrangig auf der ersten Ebene, die CMP ist laut Stape TCF-zertifiziert, und die Consent Logs liefern einen exportierbaren Nachweis ohne direkt personenbezogene Daten. Dass keine Lizenzgebühr anfällt, macht sie auch wirtschaftlich interessant, denn heute ist die CMP meist ein eigener Vertrag mit eigenen laufenden Kosten. Bei Websites mit viel Traffic sollten Sie aber den zusätzlichen Request je Seitenaufruf in die Kalkulation des Stape-Abos einrechnen. Offen bleibt, wie sie sich im Alltag gegenüber etablierten Lösungen schlägt, etwa bei Scan-Qualität, Übersetzungen und Prüfungen durch Aufsichtsbehörden. Wer mehrere Domains in einem Container betreibt, muss ohnehin noch einige Wochen warten. Für neue Server-Side-Projekte lohnt es sich, die CMP früh zu testen. Eine funktionierende CMP sollten Sie aber erst ersetzen, wenn sich die neue Lösung im Einsatz bewährt hat.
Fragen und Antworten zu ITP, Cookie Keeper und Same Origin
Im Q&A ging es außerdem um Grundlagen, die für viele Setups wichtig sind:
- Schützt eine Subdomain vor ITP? Standardmäßig nicht. Safari vergleicht bei Cookies, die eine Subdomain setzt, deren IP-Adresse mit der der Website. Nur wenn mindestens die Hälfte der IP-Adresse übereinstimmt, also beide im selben Netz liegen, gilt das Cookie als echtes First-Party-Cookie. Abhilfe schaffen Cookie Keeper oder ein Same-Origin-Setup, bei dem die IP-Adressen vollständig übereinstimmen.
- Same Origin oder Cookie Keeper? Beide führen zu einem ähnlichen Ergebnis. Cookie Keeper stellt Cookies bei jedem Aufruf wieder her, Same Origin sorgt dafür, dass Cookies ihre vorgesehene Laufzeit erreichen. Same Origin hat aber zusätzliche Vorteile, etwa beim Laden von Skripten. Stape empfiehlt deshalb klar: Wenn Stack und CDN es zulassen, Same Origin einrichten.
- Wie misst Request Analytics den Anteil mit Tracking-Schutz? Über eine Kombination aus User Agent, etwa der Safari-Version, und Signalen, die ein Skript des Custom Loaders im Browser erfasst. Werbeblocker werden auf ähnliche Weise erkannt.
- Welche Cookies verlängert Cookie Keeper? Die vollständige Liste steht im Stape-Helpdesk, erreichbar über „How it works“ im Dashboard. Fehlende Cookies kann man bei Stape melden.
Zusammenfassung: Drei Probleme, eine Plattform
Zum Abschluss des Product Showcase hat Stape seine Produktwelt noch einmal entlang der drei Probleme sortiert:
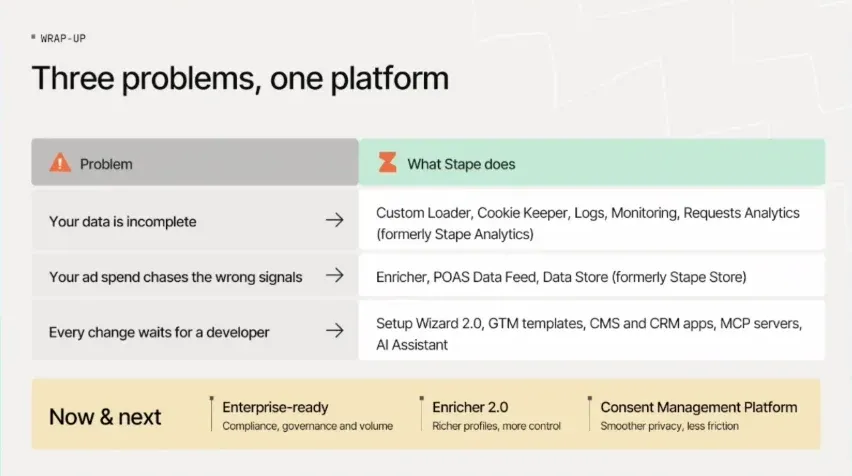
Folie aus dem Product Showcase der Stape Relay 2026 (Quelle: Stape)
| Problem | Was Stape dafür anbietet |
|---|---|
| Die Daten sind unvollständig | Custom Loader, Cookie Keeper, Logs, Monitoring, Requests Analytics (früher Stape Analytics) |
| Das Werbebudget folgt den falschen Signalen | Enricher, POAS Data Feed, Data Store (früher Stape Store) |
| Jede Änderung wartet auf einen Entwickler | Setup Wizard 2.0, GTM-Templates, Apps für CMS und CRM, MCP-Server, AI Assistant |
Als „Now & next“ stehen darunter die drei großen Neuheiten des Tages: Stape Enterprise ist bereits verfügbar, die Consent Management Platform startet am 15. November, und der Enricher 2.0 folgt bis Ende 2026.
Unter „See it in practice“ hat Stape zum Schluss auf sechs Sessions des Tages verwiesen, die einzelne Themen vertiefen: die Power-Ups für mehr Google-Ads-Conversions, die Case Study von Champion Europe, Data Enrichment im sGTM, Bidding auf vorhergesagten Umsatz, die MCP-Server und den AI Assistant sowie die Case Study von Marktplaats. Zeiten und Speaker finden Sie oben in der Agenda. Die Aufzeichnung der Konferenz schickt Stape laut Live-Chat an alle Teilnehmer, außerdem erscheint sie in Kürze auf dem YouTube-Kanal von Stape.
Session: Server-Side GTM mit Data Enrichment auf das nächste Level heben
Um 11 Uhr startete Track 2 mit Julius Fedorovicius, Gründer von Analytics Mania und einer der bekanntesten GTM-Trainer. Sein Thema: Wie Server-Side GTM durch Data Enrichment vom reinen Durchreichen von Daten zu deutlich stärkeren Signalen für GA4, Google Ads und Meta wird, etwa mit Produktmargen oder Daten aus dem CRM.
Von der Datenfestung zum Aufklärungsposten
Julius knüpfte an seinen Vortrag vom Vorjahr an. Damals ging es um die „Data Fortress“, also darum, Tracking-Daten zu schützen: gegen interne Probleme wie Bots, gegen externe wie ITP und Browser-Erweiterungen und gegen Schwachstellen durch Fehlkonfiguration.
Viele Server-Side-Setups bleiben aber genau dort stehen. Die Daten fließen von der Website über den Server-Container zur Werbeplattform, ohne dass unterwegs etwas passiert. Julius nennt das eine „Dumb Pipe“, eine dumme Leitung. Vor vier, fünf Jahren war das bahnbrechend, heute reicht es nicht mehr. Sein Appell: Schützen Sie die Daten nicht nur, sondern reichern Sie sie an, bevor sie bei den Anbietern ankommen. Der Server-Container soll zum zentralen Knotenpunkt für alle Daten werden. Daten kommen dann nicht nur von der Website, sondern auch aus E-Mail-Marketing, Shop-Backend, CRM und anderen Systemen, die sich per API anbinden lassen. Data Enrichment galt vor einigen Jahren noch als Raketenwissenschaft. Laut Julius bewegt sich die Branche genau dorthin.
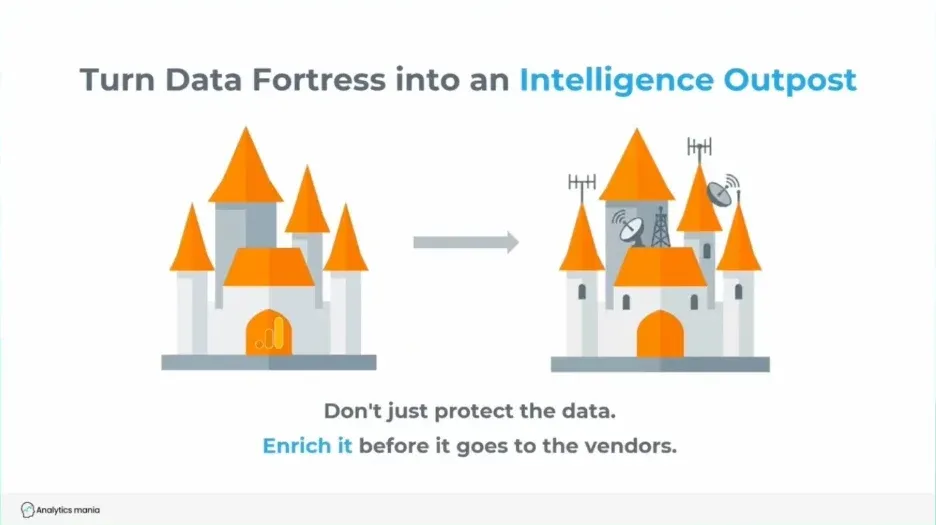
Folie aus dem Vortrag von Julius Fedorovicius (Quelle: Analytics Mania)
Beispiel 1: Gewinn statt Umsatz an Google Ads senden
Das erste Beispiel betrifft fast jedes E-Commerce-Konto. Die meisten Google-Ads-Konten optimieren auf Umsatz: Im Conversion-Tag steht als Conversion-Wert schlicht die Variable für den Bestellwert. Für den Algorithmus ist damit jeder Euro Umsatz gleich viel wert, egal wie viel Marge dahintersteht. Julius rechnete es an zwei Produkten vor:
- Produkt A kostet 30 Euro und bringt 15 Euro Marge. Eine Conversion über Werbung kostet rund 10 Euro. Das Produkt ist profitabel.
- Produkt B ist teurer und sieht für Google deshalb besser aus, weil es mehr Umsatz bringt. Die Marge beträgt aber nur 5 Euro. Bei denselben 10 Euro Kosten pro Conversion verliert das Unternehmen mit jeder Conversion Geld.
Ähnlich bei ganzen Kampagnen: Eine Kampagne mit 740 Euro Werbeausgaben kann bei Umsatz-Tracking einen ROAS von fünf zeigen und trotzdem Verlust machen, wenn der Gewinn aus den Verkäufen die Werbekosten nicht deckt. Erst Gewinn-Tracking zeigt, welche Kampagnen, Anzeigengruppen und Keywords wirklich Geld verdienen.
Die Lösung: Der Umsatz geht nicht mehr direkt von der Website an Google Ads, sondern zuerst an den Server-Container. Julius zeigte den Ablauf an einem Beispiel:
- Die Website meldet einen Kauf mit 50 Euro Umsatz an den Server-Container, nicht direkt an Google Ads.
- Der Server-Container schlägt anhand der Produkt-ID den Gewinn im Speicher nach, etwa im Stape Store.
- An Google Ads geht als Conversion-Wert der Gewinn von 10 Euro statt des Umsatzes von 50 Euro.
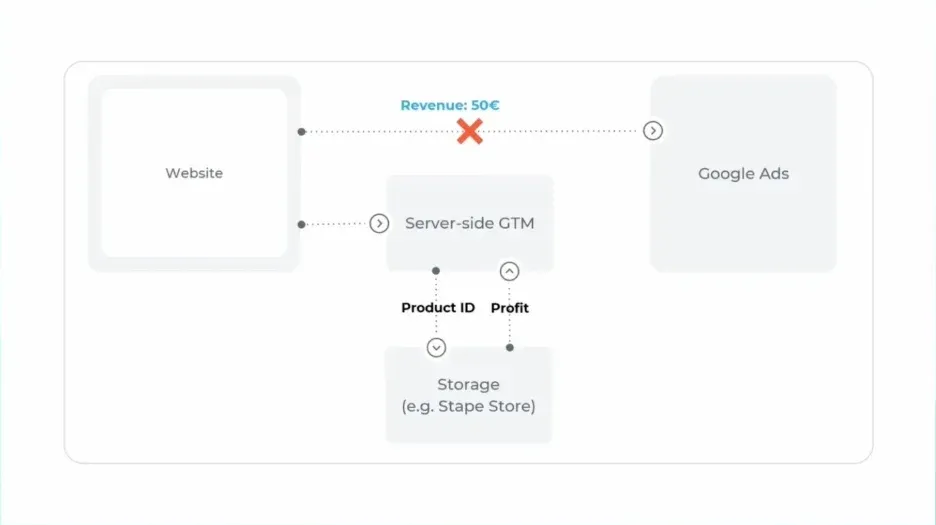
Folie aus dem Vortrag von Julius Fedorovicius (Quelle: Analytics Mania)
So sieht das im Server-GTM aus: Julius nutzt dafür die Variable „Stape Store Margin Lookup“. Als Quelle dient das GA4-Items-Array aus den Event-Daten, als Produktkennung das Feld item_id. Die Variable schlägt für jedes Produkt im Warenkorb die Marge im Stape Store nach, berücksichtigt die Menge und gibt die Summe als Zahl zurück, im Beispiel 110,98 für ein purchase-Event. Optional lassen sich die Lookups in der Konsole oder in BigQuery protokollieren. Im Google-Ads-Conversion-Tag des Server-Containers ersetzt diese Variable dann einfach den bisherigen Umsatzwert im Feld „Conversion Value“. Die Margen selbst gehören nicht in den Browser, wo Konkurrenten sie auslesen könnten, sondern liegen nur auf dem Server, etwa im Data Store oder im POAS Data Feed von Stape.
Wichtig beim Umstieg: Mit Gewinn statt Umsatz sinken die Conversion-Werte deutlich. Wer in Google Ads mit Ziel-ROAS bietet, muss das Ziel anpassen. Ein Ziel von 400 oder 500 Prozent, das auf Umsatz ausgelegt war, ist auf Gewinnbasis für viele Unternehmen nicht erreichbar. Julius empfiehlt realistischere Werte, etwa 100 bis 150 Prozent. Sonst bricht die Auslieferung ein.
Beispiel 2: Nutzerdaten für Meta über die ganze Customer Journey
Im zweiten Beispiel geht es um die Event Match Quality bei Meta. Nutzerdaten wie die E-Mail-Adresse kennt die Website meist nur in einem Moment, etwa beim Absenden eines Formulars. Spätere Events wie Seitenaufrufe oder ein Kauf kommen ohne diese Daten bei Meta an und lassen sich schlechter einem Nutzer zuordnen. Julius unterscheidet drei Stufen:
- Basis: Die Conversion geht nur mit der Klick-ID an Meta. Die Zuordnung zum Anzeigenklick scheitert heute oft an Browser-Einschränkungen.
- Besser: Die Conversion bringt gehashte Nutzerdaten mit, die im Moment des Kaufs bekannt sind, etwa die E-Mail-Adresse.
- Am besten: Der Server-Container baut über alle Besuche hinweg ein Nutzerprofil auf und hängt es an jedes Event.
Julius’ Lösung, die er „A great setup“ nennt:
- Beim Lead oder beim Kontakt erfasst der Web-GTM E-Mail-Adresse, Stadt und Land und schickt sie an den Server-Container.
- Der Server-Container speichert diese Daten im Stape Store oder in Firestore.
- Bei jedem späteren Event, ob Seitenaufruf oder Kauf, liest der Server-Container die gespeicherten Daten wieder aus und schickt sie mit dem Event an Meta.
Mit jeder Interaktion wird das Profil reicher. Besonders nützlich ist das bei individuell entwickelten oder älteren Shopsystemen, bei denen die Entwickler den dataLayer nicht so schnell um Nutzerdaten erweitern können.
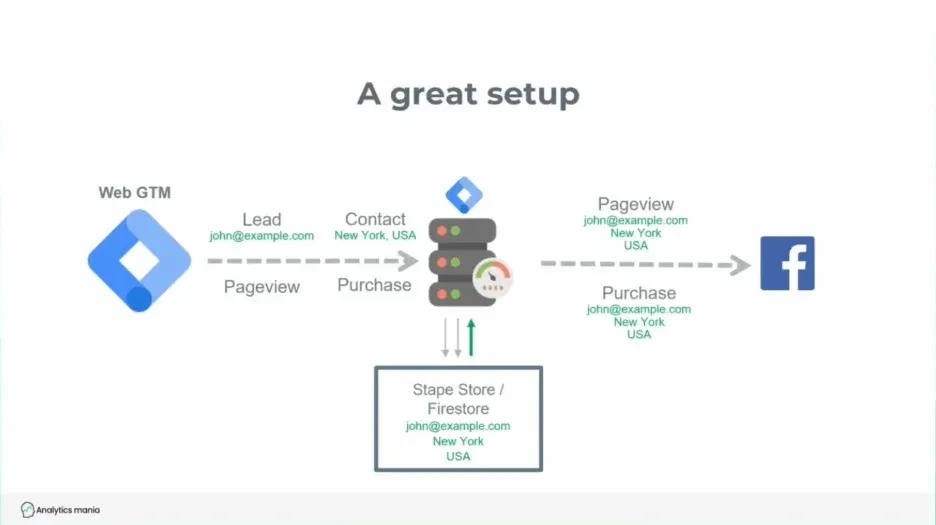
Folie aus dem Vortrag von Julius Fedorovicius (Quelle: Analytics Mania)
So sieht das im GTM aus:
- Web-GTM: Das GA4-Event
generate_leadbekommt die Parameteruser_dataundform_id.user_datafüllt eine Variable vom Typ „User-Provided Data“ in manueller Konfiguration, die E-Mail-Adresse und Telefonnummer aus dem dataLayer liest. - Server-GTM, Speichern: Ein Tag „Stape Store Writer“ schreibt die Daten in eine Sammlung im Stape Store, etwa
users. Als Dokument-ID dient im Beispiel die E-Mail-Adresse. Mit der Option „Add Event Data“ landen auch weitere Event-Daten wie die GA4-Client-ID im Dokument. - Server-GTM, Auslesen: Eine Variable „Stape Store Lookup“ holt bei späteren Events gezielt einzelne Felder aus dem Dokument, etwa
user_data.phone. Für jedes Feld braucht es eine eigene Lookup-Variable. - Server-GTM, Senden: Im Meta-CAPI-Tag für den Kauf bleibt „Automap User Data“ aktiv. Über „Server Event Data Override“ wird zusätzlich etwa die Telefonnummer mit dem Wert aus dem Stape Store ergänzt.
Was Data Enrichment bringen kann
„Die Ergebnisse können variieren“, betonte Julius. Für Gewinn-Tracking nennt er drei Effekte: Der Algorithmus erkennt besser, was wirklich funktioniert. Unprofitable Kampagnen und Keywords lassen sich abschalten. Eine Schritt-für-Schritt-Anleitung steht in unserem #GTMfaults-Artikel zum Conversion-Wert in Google Ads. Und das freie Budget lässt sich in die Kampagnen verschieben, die Gewinn bringen. Für Meta hält er eine Event Match Quality von 9 von 10 für gut erreichbar und 8 von 10 auch mit weniger Nutzerdaten. Dazu zeigte er Zahlen aus veröffentlichten Stape-Case-Studies:
| Kennzahl | Ergebnis | Case Study |
|---|---|---|
| Event Match Quality bei Meta | 9 von 10 | 1900film, Transparent Digital |
| Kosten pro Akquisition | −50 % | 1900film |
| Kosten pro Akquisition | −39 % | Transparent Digital |
| Erfasste Conversions | +162 % | Transparent Digital |
| Erfasste Conversions | +50 % | April Parfumerie |
Laut Meta kann eine höhere Event Match Quality die Kosten pro Aktion um rund 13 Prozent senken. Julius wies selbst darauf hin, dass die Zahlen nicht allein auf die bessere Match Quality zurückgehen, sondern auch auf weitere Server-Side-Funktionen wie Custom Loader und längere Cookie-Laufzeiten. Solche Werte sind Einzelfälle aus Kundenprojekten von Stape, keine Garantie. Sie zeigen aber, in welcher Größenordnung sich bessere Signale auswirken können.
Das Muster aus Beispiel 2 automatisiert übrigens Stapes Enricher, der im Product Showcase vorgestellt wurde. Wer es selbst baut, behält dafür mehr Kontrolle über die Logik.
Meine Einordnung: Beide Beispiele zeigen, warum ein Server-Container mehr sein sollte als eine Weiterleitung. Gewinn statt Umsatz ist für viele Shops der Hebel mit dem größten Effekt auf die Kampagnensteuerung, und er lässt sich mit überschaubarem Aufwand umsetzen. Beim zweiten Beispiel gilt: Personenbezogene Daten zu speichern und an spätere Events zu hängen, braucht eine saubere Rechtsgrundlage und eine Einwilligung für Marketing. Speichern Sie nur, was Sie wirklich brauchen, hashen Sie E-Mail-Adressen vor der Übertragung und legen Sie eine Speicherdauer fest. Die E-Mail-Adresse im Klartext als Dokument-ID zu verwenden, wie in der Demo, würde ich für den Produktivbetrieb in der EU nicht übernehmen. Ein Hash oder eine pseudonyme Kennung erfüllt denselben Zweck.
Julius’ Fazit: Schutz ist Pflicht, Anreicherung ist die Kür
Proxying, Custom Loader und längere Cookie-Laufzeiten waren vor einigen Jahren das große Verkaufsargument für Server-Side GTM. Heute sind sie laut Julius „Table Stakes“, also Grundvoraussetzung. Das volle Potenzial entfaltet Server-Side GTM erst, wenn Schutz und Anreicherung zusammenkommen. Wer das Thema bisher aufgeschoben hat, sollte es jetzt angehen. Für den Einstieg verwies Julius auf seinen Kurs „First-Party Data Masterclass“ bei Analytics Mania.
Session: Bidding auf vorhergesagten Umsatz mit sGTM, Firestore und Stape
Um 11:30 Uhr folgte in Track 2 Daniel Perry-Reed, Berater für Marketing Measurement und Analytics bei Kickflip Analytics. Er zeigt ein reales Setup für eine Lead-Gen-Website: Schon in dem Moment, in dem ein Lead entsteht, fließt ein vorhergesagter Umsatz in alle Marketing-Signale ein. Zusammen arbeiten dabei BigQuery, Firestore, Stape und der Server-Side GTM.
Das knüpft direkt an die Session von Julius Fedorovicius an. Dort ging es um den Gewinn im E-Commerce, hier um ein Problem, das viele B2B- und Lead-Gen-Unternehmen kennen: Zum Zeitpunkt der Conversion weiß niemand, wie viel ein Lead später wert ist. Kampagnen optimieren deshalb oft auf die Zahl der Leads statt auf ihren Wert.
Das Problem: Der Umsatz steht erst sechs Wochen später fest
Daniels Beispiel ist ein Kunde von ihm, eine Crowdfunding-Plattform aus Großbritannien. Nutzer legen dort Projekte an, etwa einen Spendenlauf für einen guten Zweck, und sammeln dafür Spenden. Die Plattform verdient an den eingesammelten Spenden. Der Weg zum Umsatz ist lang:
- Ein Besucher kommt über eine Anzeige auf die Website.
- Er legt ein Projekt an.
- Er startet das Projekt.
- Er bewirbt es und sammelt Spenden.
- Erst wenn das Projekt abgeschlossen ist, steht fest, wie viel Umsatz die Plattform damit gemacht hat.
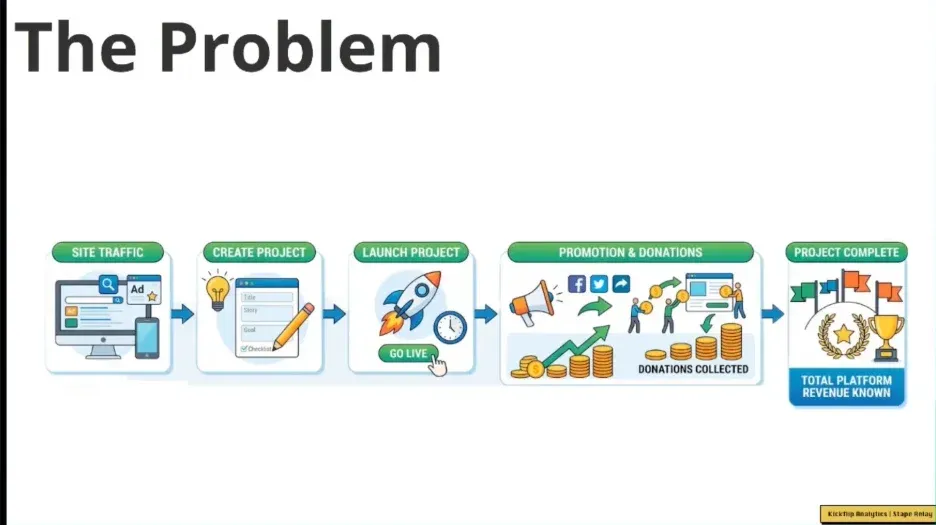
Folie aus dem Vortrag von Daniel Perry-Reed (Quelle: Kickflip Analytics)
Zwischen dem Start eines Projekts und dem feststehenden Umsatz liegen sechs Wochen oder mehr. Damit entsteht eine Kluft zwischen zwei Welten: Das Marketing sieht nur die frühen Schritte, also Besuch, angelegtes und gestartetes Projekt. Das Business sieht erst Wochen später, wie viel Geld tatsächlich hereinkommt. Dazwischen gibt es keine Verbindung.
Die Werbeplattformen brauchen ihr Signal aber früh, idealerweise beim Anlegen des Projekts. Zu diesem Zeitpunkt ist der spätere Umsatz noch völlig offen: Manche Projekte bringen viel ein, andere gar nichts. Wer hier nur „Lead“ meldet, bringt dem Algorithmus bei, möglichst viele Projekte zu erzeugen, nicht möglichst wertvolle. Und das Problem ist groß: Laut Daniel erhalten grob 40 bis 50 Prozent der Projekte nie eine einzige Spende. Behandeln die Werbeplattformen alle Projekte gleich, lernen sie, genau die falschen Nutzer anzusprechen.
Die Lösung: Ein Machine-Learning-Modell sagt den Umsatz voraus
Das Datenteam des Kunden hatte bereits vorgearbeitet: Statt sechs Wochen auf den echten Umsatz zu warten, sagt ein Modell in BigQuery ML voraus, wie viel ein neues Projekt wahrscheinlich einbringt. Die Pipeline läuft täglich, alle Zeiten britischer Zeit:
| Zeitpunkt | Schritt |
|---|---|
| Laufender Tag | Nutzer starten Projekte, die ab sofort Spenden annehmen. |
| 00:00 Uhr | Die Daten des Tages sind vollständig und werden im Data Warehouse zusammengefasst. |
| 03:00 Uhr | Die Tagesdaten werden gesammelt nach BigQuery exportiert. |
| 08:00 Uhr | Das BigQuery-ML-Modell ist durchgelaufen und gibt für jedes Projekt den vorhergesagten Wert aus. |
Vom Start eines Projekts bis zum vorhergesagten Wert vergehen so höchstens 32 Stunden: bis zu 24 Stunden bis Tagesende plus 8 Stunden Verarbeitung. Das ist deutlich schneller als die sechs Wochen bis zum echten Umsatz und liegt für die Werbeplattformen noch im nutzbaren Zeitfenster.
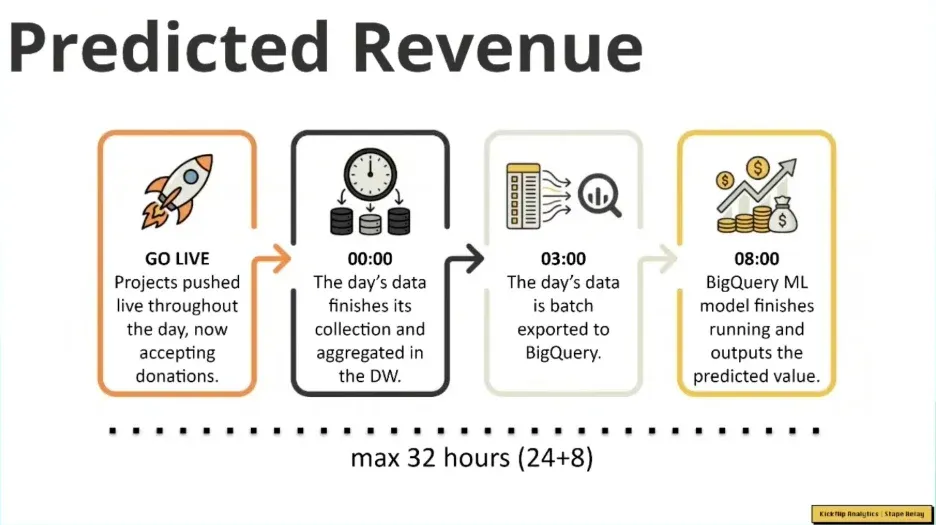
Folie aus dem Vortrag von Daniel Perry-Reed (Quelle: Kickflip Analytics)
Der Trick: Das Event 32 Stunden zurückhalten
Wie kommt der vorhergesagte Wert in die Conversion, wenn er erst bis zu 32 Stunden nach dem Projektstart feststeht? Daniels Antwort: Er hält das Conversion-Event genau so lange zurück. Der Ablauf besteht aus vier Bausteinen, alle von Stape:
- GA4-Event: Beim Start eines Projekts schickt der Web-GTM ein Event an den Server-Container. Der läuft über den Custom Loader auf der eigenen Domain.
- Request Delay: Das Power-Up „Request Delay“ hält das Event 1.920 Minuten fest, also genau 32 Stunden, und schickt es erst dann an den Server-Container weiter.
- Event Generator: Kommt das verzögerte Event an, liegt der vorhergesagte Wert längst in Firestore. Das Tag-Template „Event Generator“ erzeugt daraus ein neues Event mit diesem Wert.
- Conversion-Tags: Auf dieses neue Event reagieren die Conversion-Tags für Google Ads, Meta, TikTok und weitere Plattformen.
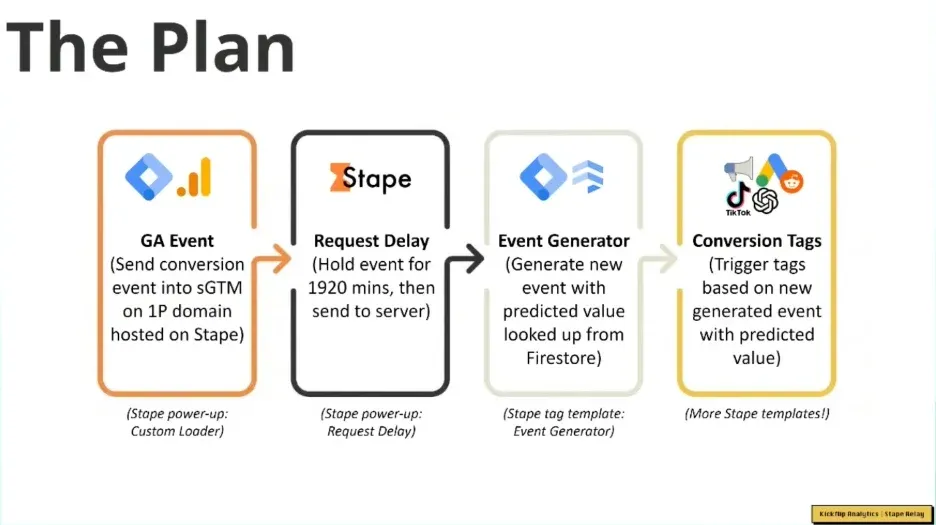
Folie aus dem Vortrag von Daniel Perry-Reed (Quelle: Kickflip Analytics)
Technisch ist die Verzögerung schlicht ein anderer Pfad im Server-Container: Das GA4-Event-Tag im Web-GTM schickt an eine Server-URL nach dem Muster /stape/delay/1920. Request Delay erlaubt Verzögerungen von 1 bis 2.000 Minuten. Bis vor Kurzem lag die Grenze bei 1.500 Minuten. Stape hat sie laut Daniel eigens für diesen Anwendungsfall auf 2.000 Minuten angehoben.
Vorher und nachher: Die Architektur
Vorher lief das Tracking über Segment: Die Website schickte Events an Segment, und Segment verteilte sie an Facebook Pixel und CAPI, TikTok, Twitter, Google Ads und Hotjar. Daneben gab es einen Google Tag Manager für Microsoft Ads und GA4. Allein für Google Ads gab es vier verschiedene Wege, Conversions zu messen. Die vorhergesagten Werte kamen bereits an, und zwar über Census: Das Tool synchronisierte die Werte täglich aus BigQuery als Offline-Conversions in Google Ads. Das hatte drei Nachteile. Die Plattform brauchte ein eigenes System, um die GCLID auf der Website zu speichern. Census kostete extra. Und das Ganze funktionierte nur für Google Ads, nicht für Microsoft, Meta oder TikTok. Die Einwilligung steuerte ein fest eingebautes Cookiebot.
Nachher ist alles um einen Server-Container bei Stape herum aufgebaut:
- Der Web-GTM läuft als First-Party-Skript über die eigene Domain. Er liest den dataLayer und den Consent-Status aus Cookiebot und bedient die Browser-Pixel für Meta, TikTok, Microsoft Ads und Hotjar.
- Der GA4-Event-Stream geht an den Server-Container, für die vorhergesagten Werte über den Umweg Request Delay.
- Der Server-Container bedient Facebook CAPI, TikTok CAPI, Google Ads Conversions und Conversion-Updates sowie GA4.
- Das Data Warehouse exportiert täglich nach BigQuery. Dort entstehen die Vorhersagen, die in Firestore landen. Der Server-Container liest und schreibt in Firestore.
Der entscheidende Unterschied: Daniel muss nicht mehr jede Werbeplattform einzeln lösen. Er löst das Problem einmal, im Server-Container. Dort steht der vorhergesagte Wert als Variable bereit, und alle Tags nutzen ihn wie jeden anderen Wert.
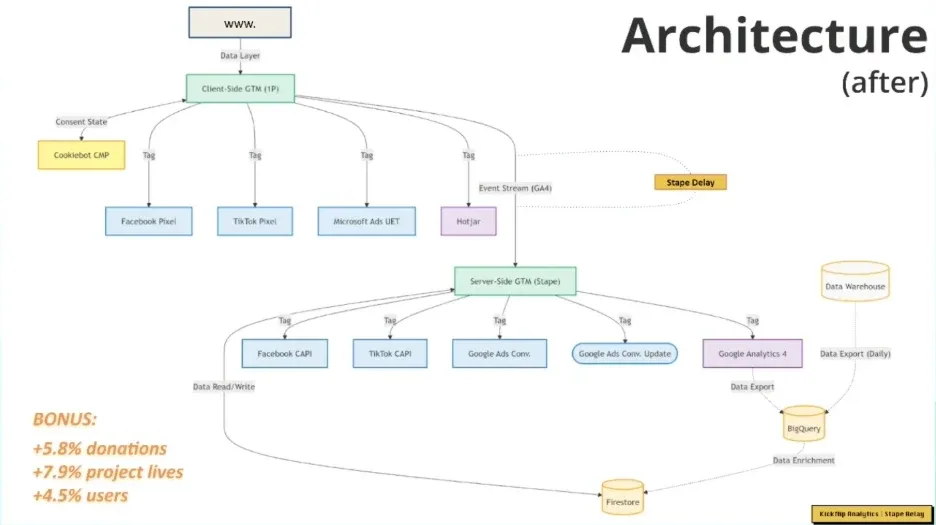
Folie aus dem Vortrag von Daniel Perry-Reed (Quelle: Kickflip Analytics)
Als Nebeneffekt der neuen Architektur mit Custom Loader und Server-Side GTM werden laut Daniel rund 5,8 Prozent mehr Spenden und 7,9 Prozent mehr gestartete Projekte erfasst. In GA4 zeigen sich 4,5 Prozent mehr Nutzer. Das sind keine zusätzlichen Spenden, sondern Daten, die vorher verloren gingen.
Details zur Umsetzung
Request Delay hält den identischen Request fest. Das Power-Up muss nur im Stape-Dashboard aktiviert werden. Im GA4-Tag des Web-GTM wird an die Server-URL der Pfad /stape/delay/1920 angehängt, die Zahl steht für die Minuten. Wichtig laut Daniel: Der zurückgehaltene Request ist exakt derselbe, mit allen Request-Headern und Cookie-Werten. Er wird nur eine Zeit lang „eingefroren“.
Event Generator statt Variable in jedem Tag. Naheliegend wäre, die Firestore-Variable direkt in jedes Conversion-Tag einzusetzen. Davon rät Daniel klar ab: Dann würde jedes Tag den Wert einzeln in Firestore nachschlagen, bei fünf oder zehn Tags also fünf- bis zehnmal pro Event. Das kostet Kontingent bei Firestore oder externen APIs. Der Event Generator schlägt den Wert genau einmal nach, erzeugt ein neues Event, im Beispiel project_live_eve, und hängt den Wert als Parameter value an. Alle Tags lösen auf dieses Event aus und finden den Wert in den Event-Daten. Für den Server-Container sieht das neue Event aus wie ein ganz normales GA4-Event. Die Stape-Templates für Meta, TikTok und andere Plattformen übernehmen das Feld value automatisch.
Firestore als „serverseitiger dataLayer“. Pro Projekt gibt es in Firestore ein Dokument mit der Projekt-ID als Schlüssel. Es enthält nicht nur einen Wert, sondern mehrere Ausgaben des Data Warehouse, zum Beispiel zwei Versionen des Vorhersagemodells. Die Variable „Firestore Lookup“ liest gezielt das gewünschte Feld aus. Daniel nutzt Firestore inzwischen für vieles, was er auf der Website nicht im dataLayer haben kann oder will.
Qualitätssicherung mit 32 Stunden Verzögerung
Die Verzögerung hat einen Haken: Man kann nicht wie gewohnt im Debug-Modus testen, sondern muss nach jeder Änderung 32 Stunden warten. Daniel hat deshalb so intensiv wie nie mit den Stape-Logs gearbeitet. Darin prüfte er, ob alle ausgehenden Requests mit Status 200 durchgingen und ob der Wert im Request an die Plattform ankam, etwa bei TikTok.
Danach kontrollierte er die Ergebnisse in den Plattformen:
- GA4: Jedes Projekt erscheint zweimal, als ursprüngliches Event und als um 32 Stunden verzögertes Event mit dem vorhergesagten Wert. Über eine gemeinsame ID ließen sich beide eindeutig zuordnen.
- Meta: Daniel hatte erwartet, dass die reine Server-Variante ohne Pixel schlechter abschneidet. Tatsächlich erhält sie dieselbe Event Match Quality wie das Original-Event. Denn es ist kein Offline-Upload: IP-Adresse, E-Mail-Adresse und Browser-ID werden wie gewohnt mitgeschickt.
- TikTok: Auch über die Events API kommen die verzögerten Events mit einer hohen Match-Qualität an.
- Google Ads: Ein Blick hinter die Kulissen wie bei Meta ist hier nicht möglich. Im Vergleich zum bisherigen Census-Upload zählt die neue Server-Conversion aber deutlich mehr Conversions, weil sie über Cookies und Enhanced Conversions statt nur über die GCLID zuordnet. Außerdem stieg der Anteil der Conversions, denen mehr als eine Anzeigeninteraktion vorausging, von 33 auf 39 Prozent.
Vor- und Nachteile
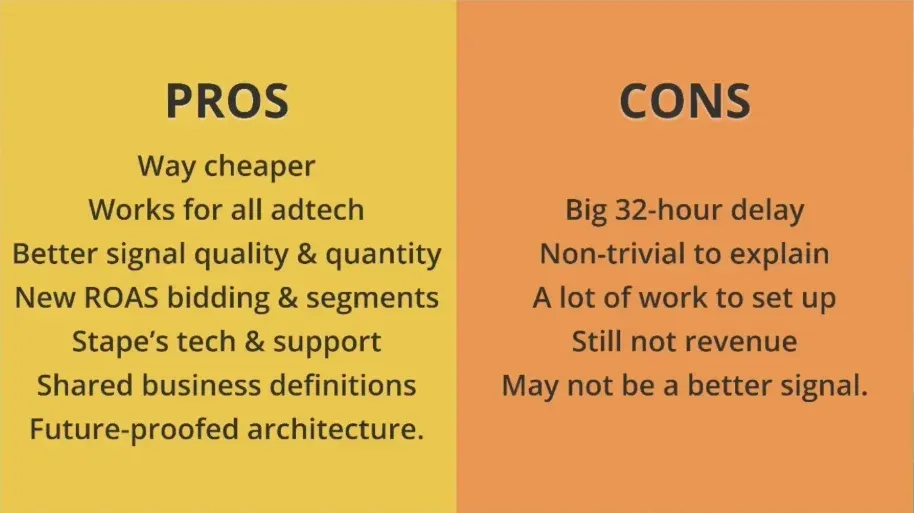
Folie aus dem Vortrag von Daniel Perry-Reed (Quelle: Kickflip Analytics)
Vorteile:
- Deutlich günstiger, weil Segment und Census wegfallen
- Funktioniert für alle Werbeplattformen, nicht nur für Google Ads
- Bessere Signalqualität und mehr erfasste Signale
- Neue Möglichkeiten für ROAS-Bidding und Segmente, mit dem vorhergesagten Umsatz als eine Art Qualitätsscore
- Stapes Technik und Support: Selbst gehostet „würde ich wohl immer noch bauen“, sagt Daniel
- Marketing und Business arbeiten mit denselben Definitionen
- Eine zukunftssichere Architektur ohne Sonderlösungen wie eigene GCLID-Speicherung
Nachteile:
- Die 32 Stunden Verzögerung wiegen schwerer als gedacht. Zielgruppen und Ausschlüsse, die auf diesem Signal beruhen, reagieren entsprechend spät. Wer gerade konvertiert hat, wird noch 32 Stunden weiter beworben. Deshalb braucht es zusätzlich ein Echtzeit-Signal.
- Das Setup ist schwer zu erklären, selbst Leuten aus der Branche.
- Die Einrichtung war viel Arbeit: neuer dataLayer, neu aufgesetzter Web-GTM, Stape-Hosting und Firestore, das der Kunde vorher nicht kannte.
- Ein vorhergesagter Umsatz ist immer noch kein echter Umsatz.
- Und das Wichtigste: Es ist nicht garantiert, dass das Signal besser ist. Bei manchen Werbeplattformen war es besser, bei anderen nicht. Daniel rät, mit dem Marketing-Team zu testen und es auch zu akzeptieren, wenn man das Signal am Ende nicht nutzt.
Meine Einordnung: Das ist für mich die praxisnaheste Session des Vormittags, weil Daniel auch zeigt, was nicht funktioniert hat. Für B2B- und Lead-Gen-Unternehmen ist der Ansatz übertragbar: Wer aus seinem CRM einen Lead-Score oder einen erwarteten Deal-Wert ableiten kann, kann ihn auf diesem Weg an Google Ads, Meta und LinkedIn senden, ohne für jede Plattform einen eigenen Offline-Upload zu bauen. Ein Vorhersagemodell ist dafür nicht zwingend nötig. Ein einfacher Score aus wenigen CRM-Feldern reicht für den Einstieg. Die Verzögerung sollten Sie so kurz wie möglich halten, und das Echtzeit-Signal sollten Sie parallel behalten.
Fragen und Antworten
- Warum Firestore und nicht Stapes Data Store? Der Kunde arbeitete schon in Google Cloud mit BigQuery, Firestore war die natürliche Erweiterung und dem Team bereits bekannt. Entscheidend war für Daniel aber die Zuständigkeit: In Firestore liegt die Vorhersage beim Datenteam, nicht beim Marketing. Die Werte lagen vorher nur in einer BigQuery-Tabelle für Reports. Daniel bat das Datenteam lediglich, sie zusätzlich nach Firestore zu schreiben.
- Verzögert das nicht alle anderen Events? Nein. Das eigentliche Event „Projekt gestartet“ läuft unverändert und in Echtzeit weiter. Verzögert wird nur ein Duplikat davon. Einen Nebeneffekt gibt es in GA4: Weil das verzögerte Event dieselben IDs trägt, ordnet GA4 es der ursprünglichen Sitzung zu, obwohl es 32 Stunden später ankommt. Das kann Auswertungen zu Sitzungen verzerren. Den Werbeplattformen ist das egal.
- Wie prüft man, ob alle verzögerten Daten ankommen? Erstens über die Stape-Logs, die drei Tage lang detailliert vorliegen. Dort sollten keine Fehler mit Status 400 oder 500 auftauchen. Zweitens über den BigQuery-Export von GA4, wo sich ursprüngliches und verzögertes Event über die gemeinsame ID abgleichen lassen. Drittens über das Tag-Template „BigQuery Writer“ von Stape: Es schreibt jedes eingehende Event direkt in eine eigene BigQuery-Tabelle. Daniel nutzte das als vorübergehendes Protokoll bis zur Abnahme.
- Wie oft wird das Modell mit dem echten Umsatz abgeglichen? Das Datenteam überarbeitet das Modell etwa jedes Quartal oder Halbjahr und prüft es gegen den tatsächlichen Umsatz. Im Einsatz ist bereits Version 2. Kommt Version 3, wird sie als weiteres Feld im Firestore-Dokument ergänzt, und im Server-Container ändert sich nur eine Variable. Wie viele Daten ein brauchbares Modell braucht, müsse jedes Unternehmen selbst bewerten. Wer seinem Modell noch nicht traut, sollte es noch nicht für das Bidding nutzen.
Session: Generalprobe auf der Live-Website
Um 12 Uhr ging es in Track 2 mit Doug Hall weiter, Technical Director bei Duga Digital. Sein Thema: Wie man große Tracking-Umbauten direkt auf der Live-Website testet, ohne echte Besucher oder echte Daten zu berühren. Gemeint ist ein neues Tag-Management-System, ein Server-Side GTM oder das Google Tag Gateway. Doug arbeitet dafür mit einer lokalen Testumgebung und einer Sandbox.
Warum eine Generalprobe?
Laut Doug bringt der Ansatz vier Vorteile:
- Kein Risiko für die Produktion: Echte Besucher und echte Daten bleiben unberührt, bis das neue Setup abgenommen ist.
- Schnellere Freigabe: Stakeholder sehen das neue Setup funktionieren, statt nur ein Konzept auf Papier zu lesen.
- Sauberes Entfernen alter Tools: Bevor man umstellt, lässt sich nachweisen, dass ein Altsystem wirklich vollständig verschwunden ist.
- Wiederholbar: Derselbe Ansatz funktioniert für jede Migration, ob GA4, Consent oder Server-Side.
Das Ausgangsproblem: Viele Änderungen gleichzeitig
Doug beschreibt ein Projekt, in dem mehrere Produktteams über mehrere Domains hinweg gleichzeitig umbauen. Jede einzelne Änderung wäre schon störend genug. Zusammen und mit der „Organisationsdynamik“ in großen Unternehmen braucht es einen geschützten Raum zum Proben. Drei Baustellen laufen parallel:
- CMS- und TMS-Migration, Consent unverändert: Das Markup der Website ändert sich durch das neue CMS, die Skripte durch das neue Tag-Management-System, und die Einwilligung muss trotzdem durchgehend funktionieren.
- Neuaufbau der Datenerfassung: Kein Flicken am Bestehenden, sondern ein komplett neues Setup aus Web-GTM und Server-Side GTM, das das heutige ersetzt.
- Abriss und Neuaufbau von Google Analytics: Die bestehende GA-Implementierung wird entfernt und von Grund auf neu gebaut, mit neuen Datenströmen und sauber konfigurierten Tags.
Das Projekt ist laut Doug real, kein Gedankenexperiment. Und das eigentliche Hindernis ist selten die Technik, sondern die Organisation: ausgelastete Teams, widersprüchliche Prioritäten, Release-Sperren und die Rolle als externe Agentur. Im Kern geht es deshalb um Risikomanagement: große Änderungen an mehreren zentralen Systemen sicher, schnell und wiederholbar machen.
Der Ansatz taugt laut Doug auch für andere Tests direkt auf der Live-Website: neue Varianten für A/B-Tests, das Entfernen sämtlicher Drittanbieter-Skripte oder eine Art Brandschutzübung, bei der man prüft, was passiert, wenn bestimmte Daten wegfallen.
Die Lösung: Ein lokaler Reverse Proxy
Dougs Werkzeug ist ein lokaler Reverse Proxy, der den eigenen Rechner glauben lässt, er spreche mit der echten Website. Alles läuft auf dem Laptop:
- Der Browser ruft wie gewohnt die echte Domain auf, etwa
https://example.com. - Die Hosts-Datei des Rechners leitet diese Domain auf den eigenen Rechner um, also auf
127.0.0.1. - Dort läuft der Reverse Proxy Caddy. Er beantwortet die HTTPS-Anfrage selbst und verteilt sie nach Pfad: Die meisten Anfragen gehen an den echten Produktionsserver, Anfragen an Tag- und sGTM-Pfade an eine Testumgebung.
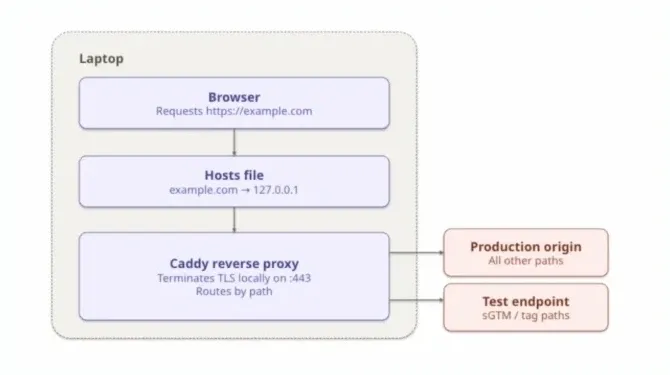
Folie aus dem Vortrag von Doug Hall (Quelle: Duga Digital)
Eine Anfrage läuft in fünf Schritten. Jeder Schritt bleibt lokal, außer dem letzten:
- Der Browser ruft die echte Domain auf, genau wie heute.
- Die Hosts-Datei leitet sie auf den eigenen Rechner um.
- Der Proxy entschlüsselt die HTTPS-Verbindung lokal mit einem Zertifikat, dem der Rechner vertraut.
- Er holt die Seite über die echte IP-Adresse vom Produktionsserver, fügt den neuen GTM-Container ein und entfernt das alte Tag.
- Die Seite kommt im Browser an, mit dem neuen Container statt des alten.
Der Schlüssel ist Schritt 3. HTTPS braucht normalerweise ein Zertifikat einer Stelle, der der Browser vertraut. Ein lokales Werkzeug legt dafür eine eigene Zertifizierungsstelle an, sodass der Proxy ein gültiges Zertifikat für die echte Domain vorweisen kann. Erst weil er die Anfrage entschlüsselt, kann er den Seitenquelltext verändern, bevor er im Browser ankommt.
Was der Proxy tut:
- Er spiegelt die echte Website über deren IP-Adresse.
- Er fügt den neuen GTM-Container in den
<head>ein. - Er blockiert das alte Tag-Management-System schon auf Netzwerkebene.
- Er setzt den Preview-Header des Server-Side GTM, sodass DebugView in GA4 funktioniert.
Was er nie tut:
- Den echten DNS ändern
- In das CMS oder das Hosting schreiben
- Irgendetwas verändern, das echte Besucher sehen
- Eine Browser-Erweiterung oder manuelle Header-Regeln voraussetzen
Ein Befehl rauf, ein Befehl runter
Doug zeigte auch das Skript, das alles steuert. Konfiguriert wird es über eine kleine .env-Datei: die ID des neuen GTM-Containers, die Domain der Website und die echten IP-Adressen der Server. Außerdem enthält es die Liste der Domains, die umgeleitet werden. Neben der eigenen Website gehört dazu auch die Domain des alten Tag-Management-Systems, im Beispiel tags.tiqcdn.com von Tealium. So lässt sich das alte System auf Netzwerkebene abschalten.
Ein Detail ist wichtig: Weil die Hosts-Datei die echte Domain auf den eigenen Rechner umleitet, kann der Proxy die echten Server-Adressen nicht mehr normal auflösen. Das Skript fragt deshalb vorab direkt einen öffentlichen DNS-Server, etwa den von Cloudflare, und merkt sich die IP-Adressen. Jede Adresse wird dreifach geprüft: Ist sie leer? Ist es eine gültige IP-Adresse? Zeigt sie womöglich schon auf den eigenen Rechner? Das würde eine Endlosschleife erzeugen.
Der Ablauf ist bewusst so gebaut, dass alles gemeinsam startet und gemeinsam endet:
| Start | Ende (Strg+C oder Stopp-Befehl) |
|---|---|
| 1. Echte Server-Adressen auflösen | 1. Proxy beenden |
| 2. Konfiguration prüfen | 2. Einträge aus der Hosts-Datei entfernen |
| 3. Aufräum-Routine für den Abbruch registrieren | 3. DNS-Cache leeren und sauber beenden |
| 4. Einträge in die Hosts-Datei schreiben | |
| 5. DNS-Cache leeren | |
| 6. Proxy starten |
Egal ob man mit Strg+C abbricht oder den Stopp-Befehl nutzt, es läuft immer dieselbe Aufräum-Routine. So bleibt kein Eintrag in der Hosts-Datei zurück, der den Rechner später unbemerkt weiter auf die Testumgebung umleitet.
Was Caddy im Detail macht
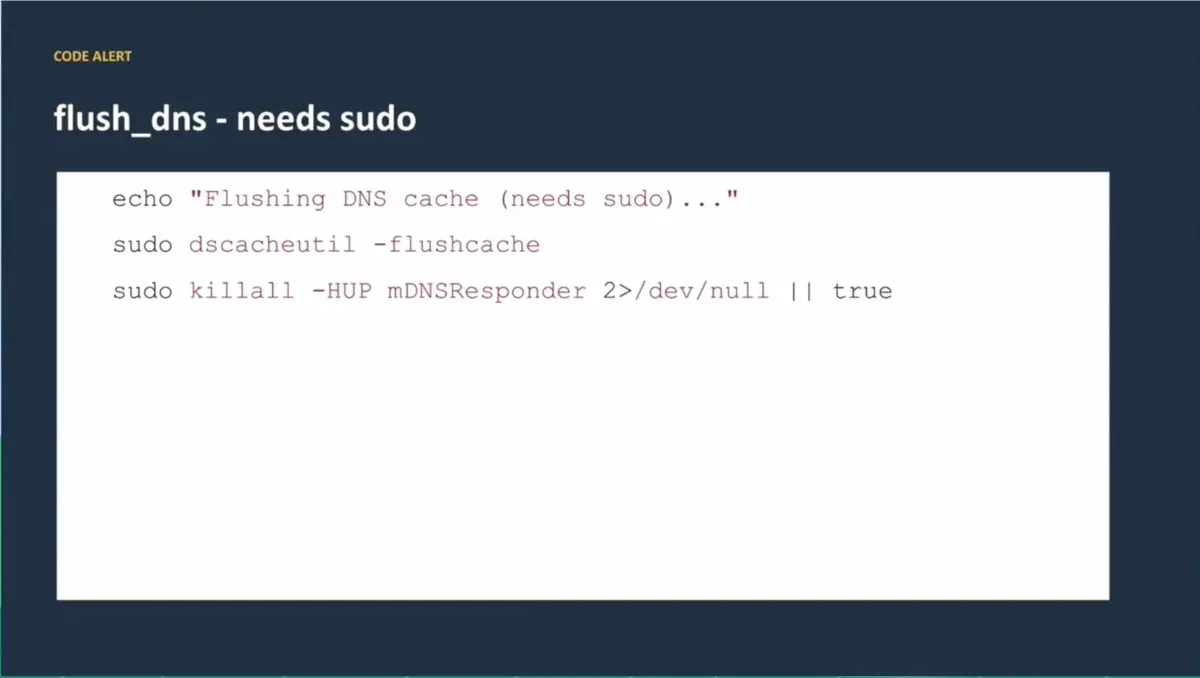
Folie aus dem Vortrag von Doug Hall (Quelle: Duga Digital)
Caddy übernimmt drei Rollen gleichzeitig:
- Für die eigentliche Website holt er die Seite vom echten Server, verändert sie und gibt sie an den Browser weiter.
- Für Tagging-Pfade leitet er die Anfrage an den Server-Container in der Sandbox weiter.
- Für das alte Tealium antwortet er mit einem leeren Skript und Status 200, sodass die Anfrage Tealium nie erreicht. Doug nennt das den „Kill Switch“.
Die Zertifikate für jede getestete Domain erzeugt das Werkzeug mkcert. Es legt eine private Zertifizierungsstelle im Vertrauensspeicher des eigenen Rechners an. Der Browser zeigt deshalb das gewohnte Schloss-Symbol, obwohl er in Wahrheit mit Caddy auf dem Laptop spricht. Wichtig: Caddy erreicht die echten Server immer über deren IP-Adresse, nicht über den Namen. Der Name zeigt ja auf den eigenen Rechner, und Caddy würde sich sonst selbst anfragen.
Besonders interessant für Server-Side-Setups ist der Teil, der das Google Tag Gateway nachbildet. Ruft die Seite den GTM über einen eigenen Pfad auf der eigenen Domain ab, schreibt Caddy diesen Pfad intern auf /gtm.js um, behält alle Parameter bei und leitet die Anfrage per HTTPS an den Sandbox-Server-Container weiter. Dabei setzt er den richtigen Host-Header, entfernt den X-Forwarded-For-Header, damit der Server nicht nur 127.0.0.1 sieht, und ergänzt auf Wunsch das Preview-Token des Server-Side GTM. Auf dem Rückweg ergänzt er die CORS-Header, damit der Browser Cookies und Antworten akzeptiert. Alle anderen Anfragen reicht er unverändert durch.
Bonus: Dasselbe Prinzip in der Produktion, am Beispiel Shopify
Ein lokaler Reverse Proxy taugt nicht für die Produktion. Doug zeigte deshalb, wie dasselbe Prinzip im Live-Betrieb funktioniert, mit einem Test-Shop bei Shopify. Die Domain des Shops läuft über Cloudflare. Davor sitzt ein Cloudflare Worker, eine kleine Funktion am Rand des CDN, die jede Anfrage an den Shop sieht.
Der Worker übernimmt die Rolle von Caddy:
- Er holt die Antwort vom Shopify-Server.
- Ist sie kein HTML, also Bild, CSS oder JSON, gibt er sie unverändert weiter.
- Ist sie HTML, fügt er mit Cloudflares HTMLRewriter den GTM-Container und das Consent-Mode-Skript in den
<head>ein. Den Consent-Teil übernimmt er selbst, weil viele CMPs mit der abgeschotteten Checkout-Umgebung von Shopify Probleme haben. - Im Checkout fügt er ein zusätzliches Skript ein.
Der Checkout ist der knifflige Teil. Normalerweise läuft Tracking dort über ein Custom Pixel in einer Sandbox, getrennt vom eigentlichen Seiteninhalt. Dougs Lösung geht anders vor: Der GTM läuft außerhalb der Sandbox, direkt auf der Seite. Das hat einen großen Vorteil, denn der dataLayer ist ganz normal in der Browser-Konsole sichtbar. Die E-Commerce-Events von Shopify entstehen aber weiterhin in der Sandbox. Sie müssen also irgendwie zum GTM gelangen.
Dafür baut Doug eine Brücke:
- In Shopify gibt es unter „Kundenereignisse“ ein kleines Pixel namens „Checkout Bridge“. Es abonniert eine feste Liste von Checkout-Events, nämlich Checkout gestartet, Kontaktdaten, Adresse, Versand, Zahlungsdaten und Kauf abgeschlossen, und zwar nur auf freigegebenen Domains.
- Tritt ein Event auf, schickt das Pixel es per
postMessagean die übergeordnete Seite, zusammen mit Metadaten wie Event-ID, Zeitstempel, Client-ID und URL. - Das vom Worker eingefügte Skript empfängt die Nachricht und prüft dreimal: Stammt sie von der Shopify-Brücke? Steht das Event auf der Liste? Kommt sie aus einem eingebetteten Frame?
- Erst dann bringt das Skript die Daten in die gewünschte Form und schiebt sie in den dataLayer.
So bestimmt man selbst, wie Datenqualität und -struktur im dataLayer aussehen, statt sich auf das Standardformat der Shopify-Events zu verlassen.
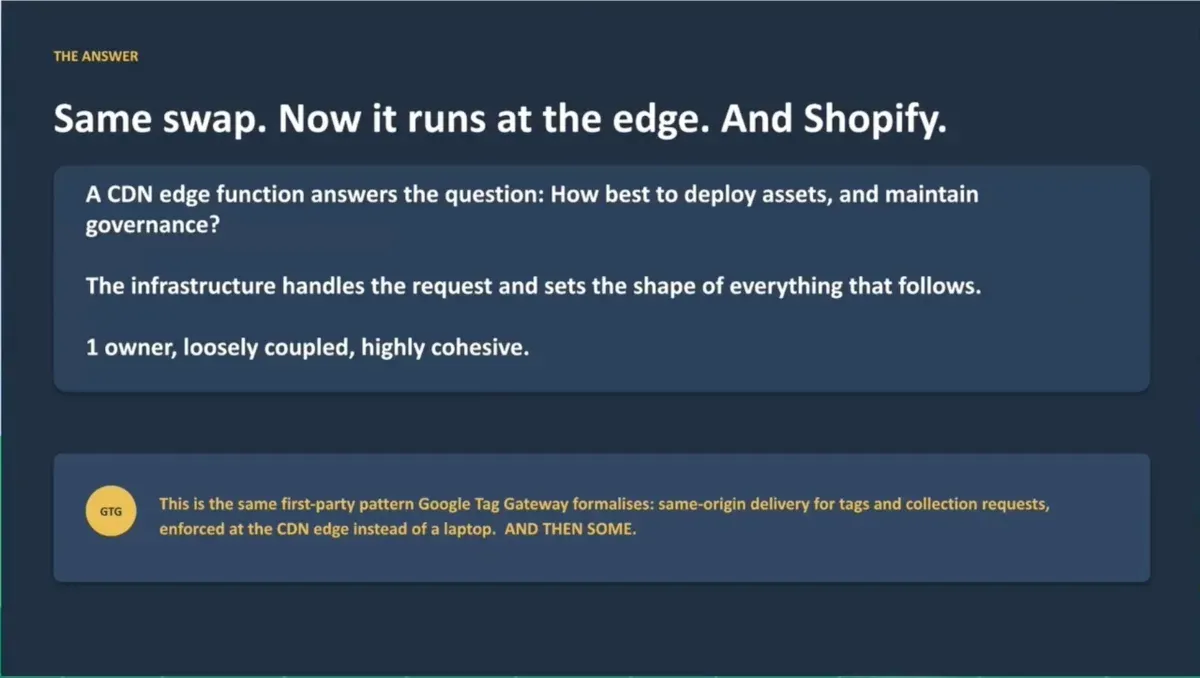
Folie aus dem Vortrag von Doug Hall (Quelle: Duga Digital)
Dougs Fazit: Lokaler Proxy und Edge-Funktion machen im Kern dasselbe. Sie schalten das alte Tracking ab und spielen den neuen Container ein. Nur der Ort ist ein anderer, einmal der eigene Laptop, einmal der Rand des CDN. Genau dieses Muster formalisiert Google mit dem Tag Gateway: Auslieferung von Tags und Messanfragen über die eigene Domain, abgesichert am Rand des CDN. Die lokale Generalprobe ist damit gleichzeitig eine Probe für das Google Tag Gateway.
Meine Einordnung: Das ist ein eleganter Weg aus einem Dilemma, das wir aus Migrationsprojekten kennen: Staging-Umgebungen bilden die echte Website selten vollständig ab, und Tests direkt in der Produktion sind riskant. Mit dem lokalen Proxy sehen Sie die echte Seite mit dem neuen Tracking, ohne dass ein einziger Besucher betroffen ist. Gerade bei Migrationen von einem Tag-Management-System zum nächsten oder beim Umstieg auf Server-Side GTM lässt sich so belegen, dass alles funktioniert, bevor die Entwickler einen Release planen. Der lokale Teil setzt allerdings Kenntnisse in Shell, DNS und TLS voraus und ist eher ein Werkzeug für erfahrene Tracking-Teams. Der Shopify-Teil ist für Shops spannend, die mit den Einschränkungen der Checkout-Sandbox kämpfen. Ein Cloudflare Worker vor dem Shop ist aber ein Eingriff in die Auslieferung des gesamten Shops. Das sollte man nur mit klarer Zuständigkeit und guter Überwachung in Betrieb nehmen.
Fragen und Antworten
- Was bringt der Reverse Proxy gegenüber normalem Server-Side Tracking? Er ist kein Ersatz, sondern ein Hilfsmittel für den Umstieg. Viele betreiben ihren Server-Container heute selbst, etwa auf Cloud Run oder App Engine. Wer zu einem Anbieter wie Stape wechseln will, tauscht eine zentrale Infrastruktur-Komponente aus. Mit dem Proxy lässt sich dieser Wechsel erst einmal nur auf dem eigenen Rechner testen. Erst wenn alle überzeugt sind, wird umgestellt. Und nie an einem Freitag, schon gar nicht vor einem Feiertag.
- Ersetzt das Setup das Google Tag Gateway für Google-, Meta- oder LinkedIn-Tags? Nein. Der Ansatz ist anbieterneutral, jedes Tag lässt sich so einspielen. Er eignet sich sogar, um eine A/B-Test-Variante auf der echten Seite zu prüfen, etwa auf Flackern. Dan Murovtsev von Stape ergänzte: Der Vergleich liegt nahe, weil das Google Tag Gateway über Cloudflare genau so arbeitet, mit Einfügen am Rand des CDN. Doug zeigte dasselbe Prinzip mit einem normalen GTM-Container.
- Wie überzeugt man Stakeholder, Zeit und Zugang zum CDN freizugeben? Erstens ist das Setup automatisiert und als Vorlage gebaut, pro Website ändert sich nur eine Datei. Zweitens sehen Stakeholder Testergebnisse statt eines Unfalls in der Produktion. Für den CDN-Zugang braucht es enge Zusammenarbeit mit dem Team, das Cloudflare oder AWS betreut. AWS ist dabei deutlich aufwendiger. Überzeugend sind am Ende greifbare Vorteile, auch für Regulierung und Compliance.
- Welche Änderung ist am gefährlichsten? Für Doug der Wechsel der Consent Management Platform, weil er rechtliche, technische und Datenqualitäts-Folgen hat. Ebenfalls heikel: der Wechsel des Server-Side-Anbieters, etwa vom selbst betriebenen Cloud Run zu Stape, und der Wechsel des Tag-Management-Systems, etwa von Tealium zu GTM. Der Einstieg in Server-Side Tracking parallel zum bestehenden Client-Side-Setup ist dagegen vergleichsweise harmlos.
- Mit welchem minimalen Test-Setup kann ein kleines Team starten? Mit dem Vorschaumodus des GTM, lokal. Wichtiger als die Technik ist laut Doug aber die Methode: wiederholbar, gründlich und nachweisbar korrekt. Dazu gehört, Ergebnisse, Vorgehen und Methodik klar an Kunden und Stakeholder zu kommunizieren. Sein Leitsatz: „Testen sollte langweilig sein.“
- Auf welches Werkzeug kann er nicht verzichten? Neben Stape: KI. Die Caddy-Syntax hat er sich mit KI-Hilfe erarbeitet, das Konzept kannte er aus Nginx. Er warnt aber davor, blind Code generieren zu lassen. Man muss wissen, was man tut. Dann lässt sich das Gelernte auch auf Nginx, Cloudflare oder AWS übertragen.
Und Doug kündigte an, die neue Stape-CMP direkt nach dem Start per Edge-Deployment zu testen.
Halbzeit: 5 Jahre Stape mit Matteo Zambon
In der Mittagspause feierte Stape sein fünfjähriges Bestehen, mit Matteo Zambon als Gast. Er ist CTO von Tag Manager Italia, erster Partner von Stape und inzwischen Product Evangelist des Unternehmens.
Neue Termine: Stape wurde bei den beiden Reveals konkreter. Die Consent Management Platform geht am Sonntag, 15. November 2026, live, ab Montag können Kunden sie nutzen. Für den Enricher 2.0 peilt Stape den 24. Dezember an, also Weihnachten.
Community-Slack: Stape startet einen eigenen Slack-Workspace für die Community. Beitreten können vorerst nur Nutzer mit einem registrierten Stape-Produkt. Die Einladung gibt es über ein Formular.
Wie Stape entstand: Matteo erzählte, wie er im Juni 2021 auf einen Dienst namens gtm-server.com stieß. Das war eine kaum angepasste WordPress-Seite ohne Impressum, über die man mit einem Google-Konto einen Server-Container hosten konnte. Es funktionierte. Über ein GitHub-Projekt fand er den Gründer Denis Golubovskyi und schrieb ihm auf LinkedIn. Sein erster Rat: den Namen ändern. Daraus wurde Stape. Was der Name bedeutet, bleibt bewusst offen. Matteos Version ist eine Mischung aus „Server“ und „Tape“, weil Server-Side Tracking fehlende Daten wieder zusammenklebt.
Matteo Zambons Blick auf die Zukunft des Trackings
- Bleibt Client-Side Tracking? Ja. Matteo schätzt, dass künftig rund 70 Prozent des Trackings serverseitig laufen. Dinge wie Session Recordings und Heatmaps brauchen aber weiterhin den Browser.
- Was bricht als Nächstes? Nicht mehr der Browser, sondern der Traffic selbst: Bots und KI-Agenten machen laut Matteo schon heute mehr Traffic aus als Menschen. Dazu kommen Protokolle, über die Agenten direkt mit dem Server oder Backend eines Shops sprechen, ganz ohne Website. Wie man diesen Traffic filtert, für das Marketing nutzt und datenschutzkonform behandelt, sei die nächste große Herausforderung.
- Wie misst man Käufe durch KI-Agenten? Bisher nur über Backend-Daten, also Webhooks und nachträgliches Übermitteln von Bestellungen, etwa mit der Shopify-App von Stape oder bei TikTok Shop. Matteo erwartet, dass Anfragen von KI-Agenten künftig eine Kennung mitbringen, ähnlich dem User-Agent im Browser. Bis dahin bleiben vor allem die Logs von Server und CDN.
Zum Partnerprogramm von Stape betonten beide Seiten den direkten Draht: Partner bekommen einen eigenen Slack-Kanal zum Stape-Team, und viele Funktionen, etwa in der Shopify-App, gehen auf Rückmeldungen von Partnern zurück.
Meine Einordnung: Der Hinweis auf KI-Agenten ist für die Messung wichtiger, als er in der lockeren Runde klang. Wenn ein Teil der Käufe nicht mehr über die Website läuft, fehlen diese Conversions im browserbasierten Tracking komplett. Unternehmen sollten deshalb schon jetzt die Grundlage schaffen: Bestellungen und Leads zusätzlich aus dem Backend an den Server-Container senden, nicht nur aus dem Browser.
Session: GTM Templates, die nächste Generation
Um 13 Uhr stellten Simo Ahava, einer der bekanntesten Köpfe der Google-Tag-Manager-Welt und Mitgründer von Simmer, sowie Giovani Ortolani Barbosa und Dan Murovtsev von Stape die gemeinsame Roadmap für die GTM-Templates vor. Stape ist nach eigener Aussage schon heute der größte Beitragende zur Community Template Gallery des GTM. Gemeinsam mit Simo sollen bestehende Templates überarbeitet und neue entwickelt werden, auf Basis von Rückmeldungen aus der Community.
So entstand die Roadmap
Die Roadmap ist das Ergebnis eines Wettbewerbs in der Community:
- Ihr habt eingereicht: Bis zum 31. Oktober konnte jeder Vorschläge einreichen, entweder Verbesserungen für bestehende Stape-Templates oder ganz neue Templates.
- Wir haben bewertet: Simo Ahava und das Stape-Team sind jede Einreichung gemeinsam durchgegangen.
- Heute die Vorstellung: Die finale Roadmap wird live auf der Stape Relay präsentiert.
- Wir bauen: Die ausgewählten Templates werden bis Ende 2026 entwickelt und veröffentlicht.
Auf die Roadmap kamen Vorschläge, die mindestens eines von drei Kriterien erfüllen:
- Nützlich für viele: Das Template löst ein Problem für viele Setups, nicht nur für einen Einzelfall.
- Versteckter Bedarf: Es adressiert ein übersehenes Problem, für das es bisher keine Standardlösung gibt.
- Mehrwert freischalten: Es verbessert die Datenqualität und ermöglicht bessere Auswertungen.
Simo Ahava war von den Einreichungen beeindruckt. Vor sechs Jahren hätte die Liste ganz anders ausgesehen, sagt er. Heute seien die Vorschläge realistisch, ohne „Moonshots“, die technisch gar nicht machbar sind. Ausgewählt wurden Templates, die echten Mehrwert bringen, in überschaubarer Zeit umsetzbar sind und der ganzen Community nützen, nicht nur einem einzelnen Anbieter.
Die Templates auf der Roadmap
US Privacy Signals (1. Platz): Viele Websites mit US-Traffic setzen nicht auf den Google Consent Mode, der vor allem auf Europa zugeschnitten ist. Die US-Datenschutz-Signale sind aber ein Flickenteppich: das Browser-Signal Global Privacy Control (GPC), CCPA/CPRA in Kalifornien, das IAB-GPP-Signal und weitere. Im Server-Container lassen sie sich ohne Consent Mode bisher nicht auslesen. Unternehmen müssen deshalb entweder den gesamten US-Traffic blockieren oder alles erfassen, was rechtlich riskant sein kann. Geplant ist eine Variable im Server-Container, die all diese Signale liest und ein klares Ergebnis liefert: „erlauben“, „eingeschränkt“ oder „blockieren“. Das lässt sich in Tags, Triggern und anderen Variablen weiterverwenden. Stape will außerdem seine Tags für Meta (Conversions API) und TikTok so erweitern, dass sie das Ergebnis direkt in ihr Feld für „Limited Data Use“ übernehmen. Für Ausweichfälle sind Einstellungen geplant: Erkennt die Variable kein Signal, greift der Consent Mode. Für bestimmte Regionen lässt sich festlegen, dass immer blockiert oder immer erlaubt wird.
Item ID Builder (2. Platz): Die Produkt-IDs im dataLayer passen selten zu den IDs im Google Merchant Center oder in den Katalogen von Meta und TikTok. Dann funktionieren dynamisches Remarketing und Produktberichte nicht richtig. Ein einfacher Übersetzer von GA4-IDs in die Formate der Plattformen wäre laut Simo fast trivial. Spannend macht das Template etwas anderes: eine eigene kleine Vorlagensprache. In einer Tabelle definiert man Variablen, etwa „Land = US“ oder „Region aus den Event-Daten“. In einem Textfeld setzt man sie dann über Platzhalter zu beliebigen IDs zusammen, zum Beispiel shopify_SE_8123456789_44556677. Für die gängigen Plattformen gibt es Voreinstellungen. Damit wird der Item ID Builder zum universellen ID-Übersetzer, ganz ohne eigenes JavaScript, das es im Server-Container ohnehin nicht gibt. Simo sieht darin eine Blaupause für künftige Stape-Templates. Gedacht ist es vor allem für Shops auf Shopify und WooCommerce, die in mehreren Ländern verkaufen.
Erster und letzter Kontakt bis zur Conversion (3. Platz): Das komplexeste Vorhaben, denn es ist ein ganzes Paket aus Templates:
- Attribution Collector: speichert UTM-Parameter, Klick-IDs wie GCLID und FBCLID, Referrer und Landingpage, und zwar für jeden Kontakt vom ersten bis zum letzten vor der Conversion.
- Attribution Touch Store: legt diese Kontakte im Stape Store oder in Firestore ab und liefert sie bei der Conversion wieder aus. Wie lange ein Kontakt als eigener Kontakt gilt, lässt sich einstellen.
- Channel Grouping: verlagert die Regeln für die Kanalgruppierung aus GA4 in den GTM, sodass die Kanäle auch an Google Ads, Meta oder BigQuery gehen können.
Die Daten lassen sich dann zum Beispiel für Zielgruppen in Google Ads, für benutzerdefinierte Conversions bei Meta, für Berichte in GA4 oder für Analysen in BigQuery nutzen. Simo machte aber deutlich, wie viele Grundsatzfragen offen sind: Kontakte über den Seitenaufruf hinaus zu speichern, setzt eine Einwilligung voraus. Die fehlt auf der Landingpage oft noch. Was passiert mit fehlenden Kontakten? Welche Kanalliste dient als Grundlage? Und wie viel davon gehört überhaupt in den GTM statt ins Data Warehouse? Weicht die Attribution im GTM von der in GA4 ab, muss man das erklären können. Seine Prognose: 80 Prozent Diskussion, 20 Prozent Programmierung.
Microsoft Ads UET Pixel (4. Platz): Das UET-Tag von Microsoft Ads im Web-GTM einzurichten, ist bisher viel Handarbeit. Stape baut, wie schon für andere Plattformen, ein eigenes Template für das Browser-Pixel. Es bündelt Seitenaufrufe und Conversion-Events in einer übersichtlichen Oberfläche und soll auch die Probleme mit doppelt gezählten Events bei Microsoft entschärfen.
Die Gewinner und wie es weitergeht
| Platz | Name | Idee | Preis |
|---|---|---|---|
| 1 | Swapnil Jaykar | US Privacy Signals | Ein Kurs nach Wahl bei Simmer |
| 2 | Viktor Sennton | Item ID Builder | Sofortbildkamera, Tasse und T-Shirt |
| 3 | Jannis Rothe | Attribution Collector, Touch Store und Channel Grouping | Sofortbildkamera, Tasse und T-Shirt |
| 4 | David Lüchinger | Microsoft Ads UET Pixel | Sofortbildkamera, Tasse und T-Shirt |
| Besondere Erwähnung | Giordano Tabacco | ähnliche Ideen zur Attribution | Tasse und T-Shirt |
Simmer, die Lernplattform von Simo Ahava, hat nach seinen Angaben rund 3.500 Lernende. Ausgenommen vom Gewinn ist nur der neue Kurs „AI for Technical Marketers“.
Gebaut wird in dieser Reihenfolge: zuerst die Attribution, weil sie am meisten Planung braucht, dann der Item ID Builder, danach als „Kronjuwel“ US Privacy Signals. Das Microsoft-Pixel kommt dazwischen, sobald Zeit ist. Ziel ist, alle Templates bis Ende 2026 zu veröffentlichen. Die Ideengeber werden in den Templates, in den README-Dateien auf GitHub und in den begleitenden Artikeln genannt. Neue Ideen nimmt Stape weiter im Community-Slack und im Stape-Forum entgegen.
Simo wies noch auf einen unterschätzten Weg hin: Jedes Template in der Community Template Gallery ist ein öffentliches GitHub-Repository, erreichbar über den Repository-Link im Template. Dort kann jeder ein „Issue“ anlegen, um einen Fehler zu melden oder eine Idee einzubringen, ganz ohne Programmierkenntnisse. Wer programmiert, kann das Template forken, selbst korrigieren und die Änderung als Pull Request zurückgeben.
Fragen und Antworten
- Lassen sich auch Anzeigen-Impressionen als Kontakt erfassen? Nein. Impressionen entstehen auf der Plattform des Anbieters und werden nicht mit einem Klick übergeben. Sie gehören in die Auswertung im Data Warehouse, wo man sie mit den Daten aus dem Stape Store oder aus Firestore kombinieren kann.
- Wie groß darf ein Template sein? Eine feste Grenze gibt es nicht. Giovanni Ortolani Barbosa baut zuerst alles ein, prüft dann die Größe und entfernt, was nicht gebraucht wird, etwa automatisches Mapping oder ausführliches Logging. Simos Faustregel: so klein wie möglich. Die Größe beim Laden über das Netz sei meist das kleinere Problem, weil Templates kompakt kodiert werden. Kritischer ist der Speicherplatz des Containers in der GTM-Oberfläche, für den Google die Grenzen kürzlich angehoben hat. Logging, Kommentare und Tests machen Templates robuster, aber auch größer. Wer ein Template nur für sich nutzt, kann eine schlanke Kopie anlegen, verliert damit aber automatische Updates. Und: Nicht genutzte Templates und alles andere Überflüssige regelmäßig aus dem Container löschen.
Meine Einordnung: Die Auswahl zeigt gut, wo es im Alltag hakt: Produkt-IDs, die nicht zum Katalog passen, Attribution über lange Entscheidungswege und Datenschutz-Signale außerhalb Europas. Für deutsche Unternehmen sind vor allem der Item ID Builder und die Attribution-Templates interessant. Simos Einwände zur Attribution sollte man ernst nehmen: Ohne Einwilligung auf der Landingpage fehlt gerade der erste Kontakt, und für viele Fragen ist das Data Warehouse der bessere Ort. US Privacy Signals wird relevant, sobald Sie Besucher oder Kunden in den USA haben. Dass Simo Ahava die Auswahl mitverantwortet, spricht für die Qualität der künftigen Templates.
Session: Server-Side Tracking 2027, das richtige Setup für Ihre Ziele
Um 14 Uhr sprach Jenny Bachmann, Senior Marketing Technology Consultant bei mohrstade, in Track 1. mohrstade ist eine 2019 gegründete Beratung für Marketing-Technologie mit Standorten in München, Potsdam und Wien. Ihre Session ist eine Entscheidungshilfe: Welches Tracking-Setup passt zu welchen Geschäftszielen, von Client-Side über Server-Side bis zum Google Tag Gateway?
Fünf Stellschrauben bei der Wahl des Setups
Mit der Wahl des Tracking-Setups lassen sich laut Jenny fünf Dinge beeinflussen. Unabhängig davon muss die Einwilligung immer sauber umgesetzt werden.
- Cookie-Laufzeit: In restriktiven Browsern wie Safari und auf allen Apple-Geräten haben Cookies eine begrenzte Laufzeit. Kehrt ein Nutzer nicht rechtzeitig zurück, gilt er als neu. Die Customer Journey wirkt dann zerstückelt: Neue Nutzer kaufen scheinbar direkt, ohne vorherige Kontakte, und Kennzahlen wie neue gegenüber wiederkehrenden Nutzern oder Kohorten werden verzerrt.
- Ladezeit der Website: Jedes Marketing-Skript muss geladen werden. Je nachdem, woher es kommt, vom eigenen Webserver, von einem Drittanbieter oder über ein CDN, wirkt sich das unterschiedlich auf die Ladezeit aus.
- Anreichern, Entfernen und Schützen von Daten: Nur mit Server-Side Tracking steht ein Server als Vermittler zwischen Website und Werbeplattformen. Dort lassen sich Daten anreichern, entfernen und personenbezogene Daten zurückhalten, statt sie direkt an Anbieter zu geben.
- Kosten: Tracking ist zunächst oft kostenlos, gerade im Google-Ökosystem. Server-Side Tracking braucht aber Hosting, Einrichtung und Wartung. Auch zusätzliche Skripte und viele Server-Anfragen können Kosten verursachen.
- Schutz vor Werbeblockern: Tracking-Pfade, URLs und Skripte von Google, Matomo oder Adobe sind leicht erkennbar und werden deshalb leicht blockiert. Wer diese Muster verschleiert, wird seltener blockiert.
Tracking, Tagging und Gateway
Jenny trennt drei Bausteine sauber voneinander:
- Client-Side Tracking: Ein Skript auf der Website erfasst Interaktionen und Events und schickt sie an Plattformen wie GA4. Damit beginnt jedes Tracking.
- Server-Side Tagging: Der Server-Container erfasst selbst nichts. Er empfängt, was im Browser erfasst wurde, und verteilt einen eingehenden Hit an mehrere Ziele wie GA4, Google Ads und Meta. Deshalb spricht Jenny von „Tagging“, nicht von „Tracking“.
- Google Tag Gateway: etwas grundlegend anderes. Es ersetzt keinen der beiden anderen Bausteine, sondern legt eine zusätzliche Schicht darüber.
Daraus ergeben sich vier mögliche Setups: nur Client-Side, Client-Side mit Google Tag Gateway, Client-Side plus Server-Side oder Client-Side plus Server-Side mit Google Tag Gateway.
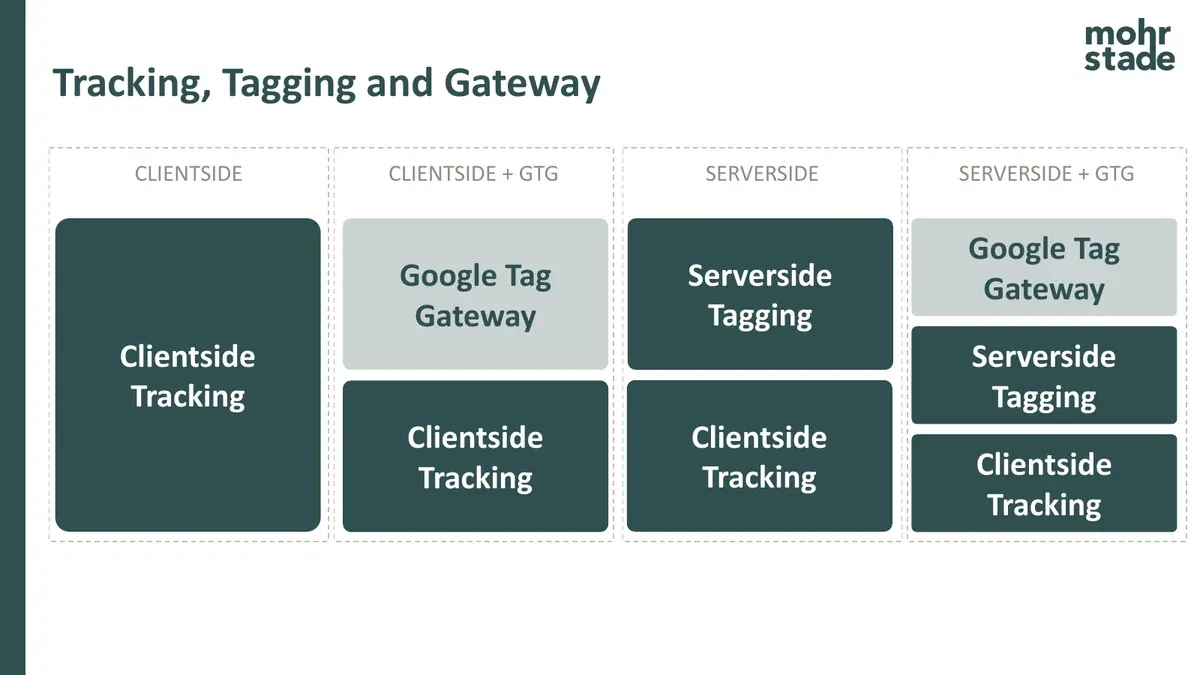
Folie aus dem Vortrag von Jenny Bachmann (Quelle: mohrstade)
Das reine Client-Side-Setup: Der Browser lädt die Website vom eigenen Webserver, und mit ihr den GTM. Ohne Anpassungen kommt das GTM-Skript direkt von googletagmanager.com, und die Daten gehen direkt an GA4 und Google Ads. Alle Pfade sind damit leicht als Tracking zu erkennen.
Jenny bewertet jedes Setup anhand von Safari, weil es am restriktivsten ist. Chrome schränkt weniger ein, aber fast jede Website hat gemischten Traffic. Für das reine Client-Side-Setup sieht die Bilanz so aus: Cookies leben in Safari höchstens 24 Stunden, die Ladezeit verbessert sich nicht, Daten lassen sich nicht anreichern, und gegen Werbeblocker gibt es keinen Schutz. Dafür ist es kostenlos.
Client-Side mit Google Tag Gateway: Das Google Tag Gateway stellt einen öffentlichen Endpunkt bereit, über den sich das GTM-Skript abrufen lässt. Die Endpunkte haben die Form GTM-XXXXXX.fps.goog, welches Skript geladen wird, bestimmen Parameter in der URL. Der Endpunkt selbst ist kostenlos. Wer per Reverse Proxy oder Routing einen Pfad der eigenen Website auf diesen Endpunkt leitet, liefert GTM und Messanfragen über die eigene Domain aus. Für den Browser sieht das aus wie ein Angebot aus demselben Ursprung, also First-Party. Die Bilanz:
- Cookies leben in Safari jetzt sieben Tage statt 24 Stunden. Es bleiben aber per JavaScript gesetzte Cookies, die weniger wert sind als Cookies, die ein Server setzt.
- Die Ladezeit lässt sich etwas verbessern, je nachdem, welches CDN oder Routing die Skripte ausliefert.
- Anfragen und Inhalte sind teilweise verschleiert, Werbeblocker greifen seltener.
- Daten lassen sich weiterhin nicht anreichern.
- Es bleibt kostenlos.
Client-Side plus Server-Side, die Standardvariante: Die GA4-Anfragen gehen an einen Server-Side GTM, der sie an GA4, Google Ads und weitere Ziele verteilt. Das GTM-Skript kommt aber weiterhin direkt von Google. Neu ist, dass der Server das GA4-Cookie per Server-Antwort setzt, also stabiler und sicherer. Die Bilanz:
- Zum ersten Mal lassen sich Daten anreichern und entfernen, personenbezogene Daten zurückhalten und eine zusätzliche Sicherheitsschicht einziehen.
- Dafür entstehen Kosten für Hosting, Einrichtung und Wartung.
- Die Cookie-Laufzeit bleibt trotzdem schlecht. Der Server-Container liegt meist bei GCP, Azure oder einem anderen Anbieter, also nicht im selben IP-Bereich wie die Website. Safari behandelt seine Cookies deshalb weiter wie Drittanbieter-Cookies und begrenzt ihre Laufzeit. Jenny nannte dafür 24 Stunden. Laut WebKit liegt die Grenze für so gesetzte Server-Cookies bei sieben Tagen, 24 Stunden gelten bei Link-Dekoration für JavaScript-Cookies. Am Kern ändert das nichts: Ohne Same Origin bleibt die Laufzeit begrenzt. Mehr dazu in unserem #GTMfaults-Artikel zu Server-Side GTM und der Cookie-Laufzeit in Safari.
- Die Ladezeit lässt sich teilweise verbessern, weil manche Skripte von Server zu Server statt im Browser laufen.
- Werbeblocker greifen weiterhin oft, weil kaum etwas verschleiert wird.
Server-Side mit Subdomain für das GTM-Skript: Lädt man zusätzlich das GTM-Skript über die Subdomain des Server-Containers, bringt das laut Jenny kaum etwas. Der Pfad gtm.js bleibt erkennbar, und je nach Hosting steigen die Kosten, weil auch die Skripte über den Server laufen. Bei GCP fallen dafür zusätzliche Kosten an, bei Stape nach ihrer Einschätzung nicht. Seit dem Update der GTM-Destinations ist es immerhin etwas günstiger geworden.
Tag Serving Path: Eine recht neue, bereits im Server-Side GTM eingebaute Option ersetzt gtm.js durch einen eigenen Pfad. Das verschleiert die Anfragen etwas mehr, Werbeblocker greifen seltener.
Same Origin: Hier lädt die Website den GTM über einen Pfad der eigenen Domain. Ein Reverse Proxy oder Routing auf dem Webserver leitet diesen Pfad an den Server-Side GTM weiter, der die Skripte ausliefert und mit Google kommuniziert. Weil alles hinter demselben Webserver liegt, kommen die Antworten von derselben IP-Adresse wie die Website. Die Cookies gelten damit als First-Party. Für Jenny ist das das Ziel, weil es die beste Cookie-Laufzeit bringt.
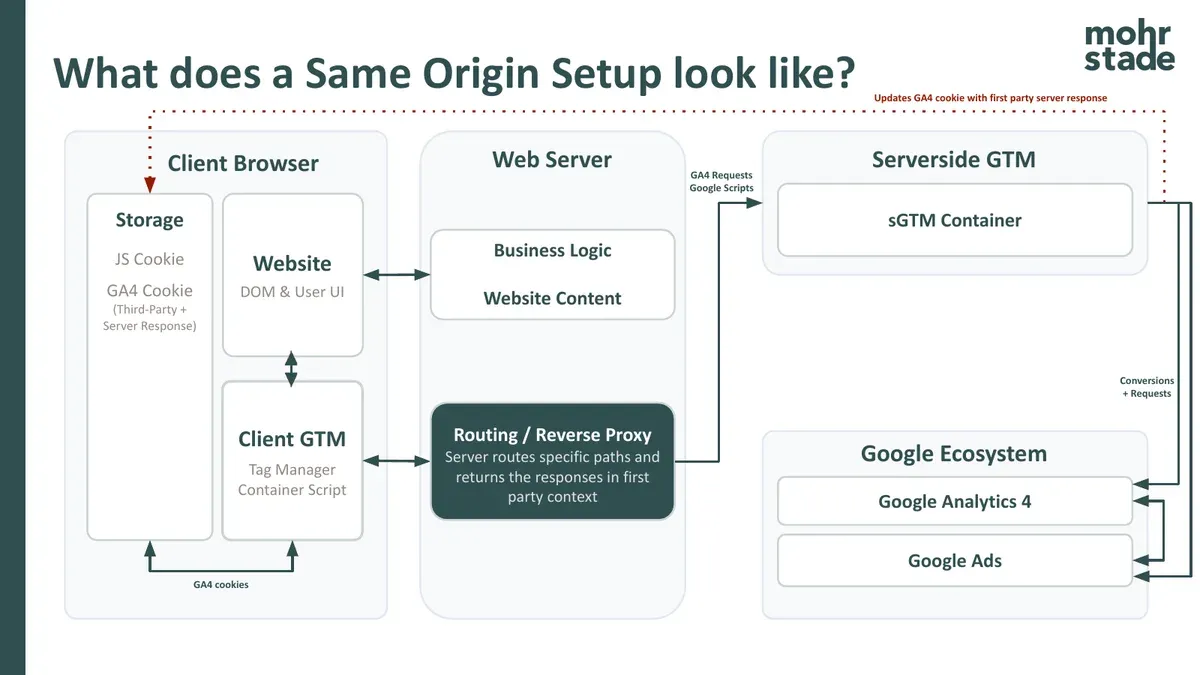
Folie aus dem Vortrag von Jenny Bachmann (Quelle: mohrstade)
Voraussetzung: Mindestens die ersten beiden Blöcke der IP-Adresse von Webserver und Tracking-Server müssen übereinstimmen. Safari begrenzt die Cookies dann nicht mehr. Lädt man zusätzlich die Skripte über einen Pfad der eigenen Domain und nutzt den Tag Serving Path, sind weder googletagmanager.com noch gtm.js erkennbar. Ganz vermeiden lässt sich das Blockieren laut Jenny nie, weil Muster erkennbar bleiben. Es ist aber deutlich sicherer als ohne Verschleierung. Dafür steigen die Kosten, weil die Skripte über den eigenen Server laufen.
Same Origin plus Google Tag Gateway: Die Kombination, bei der jedes Werkzeug tut, was es am besten kann. Der Webserver leitet zwei Pfade weiter: einen für die Messanfragen an den Server-Side GTM, der sie annimmt, anreichert, bereinigt und an die Plattformen weitergibt. Den anderen für die Google-Skripte an das Google Tag Gateway, das sie kostenlos und schnell ausliefert. Weil die Skripte nicht mehr über den eigenen Server laufen, sinken die Kosten wieder. Alles läuft im First-Party-Kontext. Die Bilanz: keine Begrenzung der Cookie-Laufzeit, bessere Ladezeit, Anreichern möglich, moderate Kosten und ein guter Schutz vor Werbeblockern.
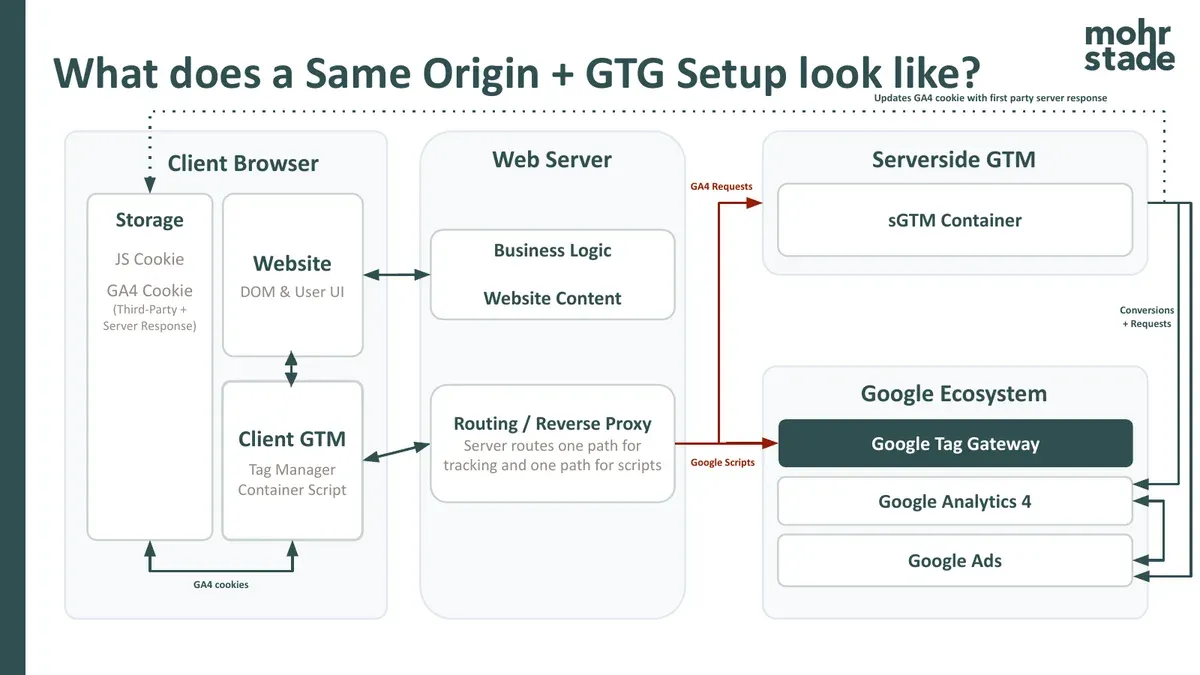
Folie aus dem Vortrag von Jenny Bachmann (Quelle: mohrstade)
Jennys Vergleich auf einen Blick
| Setup | Cookie-Laufzeit (Safari) | Ladezeit | Anreichern und Entfernen | Kosten | Werbeblocker |
|---|---|---|---|---|---|
| Client-Side | 24 Stunden | länger | nicht möglich | kostenlos | blockieren wahrscheinlich |
| Client-Side + Google Tag Gateway | 7 Tage | teilweise kürzer | nicht möglich | kostenlos | blockieren seltener |
| Server-Side | 24 Stunden | teilweise kürzer | möglich | Kosten | blockieren wahrscheinlich |
| Server-Side + Skripte über Subdomain | 24 Stunden | teilweise kürzer | möglich | höhere Kosten | teilweise seltener |
| … + Tag Serving Path | 24 Stunden | teilweise kürzer | möglich | höhere Kosten, seit dem Update der GTM-Destinations etwas günstiger | seltener |
| Server-Side + Same Origin + Skripte über Pfad + Tag Serving Path | keine Begrenzung | teilweise kürzer | möglich | höhere Kosten | seltener |
| Server-Side + Same Origin + Google Tag Gateway | keine Begrenzung | teilweise kürzer | möglich | Kosten | seltener |
Übersetzt nach der Übersichtsfolie von Jenny Bachmann (Quelle: mohrstade)
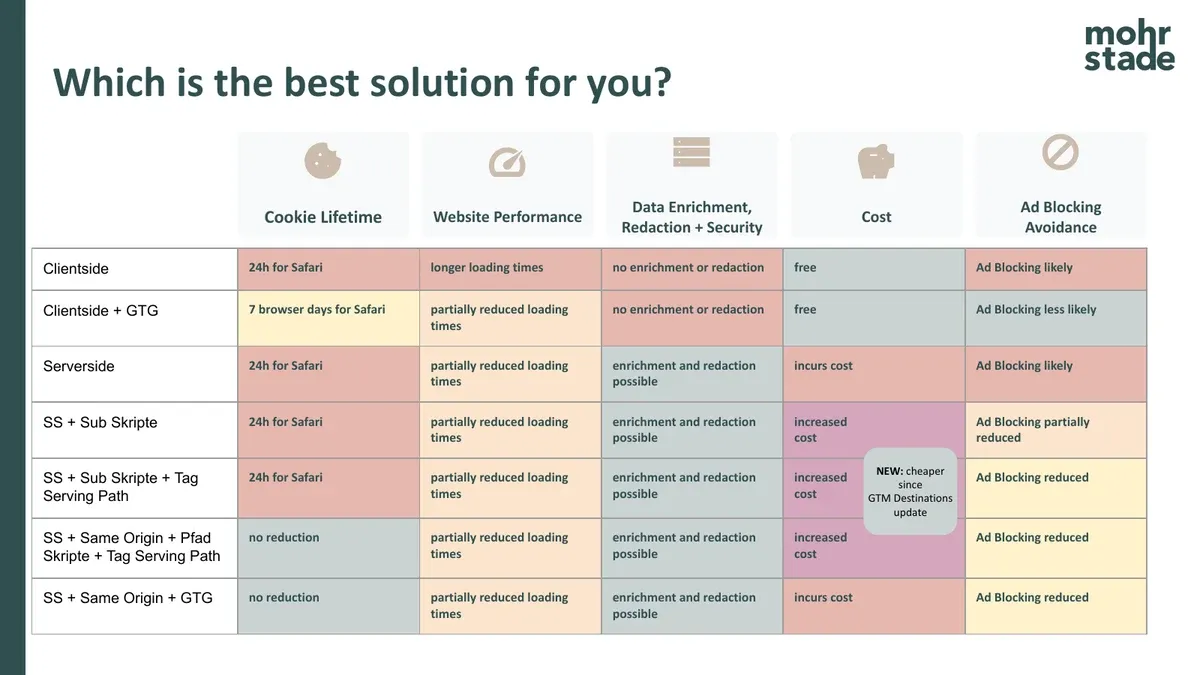
Die Original-Folie zum Vergleich (Quelle: mohrstade)
Welches Setup passt zu welchem Ziel?
Jennys Empfehlung richtet sich nach dem wichtigsten Ziel:
- Vollständige Customer Journey: Setups mit der längsten Cookie-Laufzeit, also Client-Side mit Google Tag Gateway oder, besser, Server-Side mit Same Origin, entweder mit Pfad und Tag Serving Path oder mit Google Tag Gateway.
- Niedrige Kosten: Setups, bei denen die Skripte nicht über den eigenen Server laufen, sondern direkt von Google oder über das Google Tag Gateway kommen.
- Schutz vor Werbeblockern: alles mit zusätzlicher Verschleierung, also Google Tag Gateway, Subdomain, eigener Pfad oder Tag Serving Path.
- Sicherheit und Anreicherung: Server-Side, egal ob in einer gemanagten Cloud oder über Anbieter wie Stape.
Wer die Kosten weiter senken will, kann laut Jenny von gemanagten Cloud-Diensten auf eigene virtuelle Maschinen in der Google Cloud oder sogar auf eigene Server wechseln. Das ist günstiger, braucht aber deutlich mehr Wartung und Know-how im eigenen Haus. Wer dagegen noch besser vor Werbeblockern geschützt sein will, sollte in die andere Richtung gehen, hin zu spezialisierten Server-Side-Anbietern wie Stape. Die entwickeln laut Jenny schneller als Google selbst. Funktionen wie der Custom Loader oder verschlüsselte Anfragen und Inhalte schützen derzeit deutlich besser vor Werbeblockern als Googles eingebaute Werkzeuge.
Meine Einordnung: Für mich ist das die nützlichste Entscheidungshilfe des Tages, weil sie mit einem verbreiteten Irrtum aufräumt: Ein Server-Container allein verlängert die Cookie-Laufzeit in Safari nicht. Erst Same Origin, also gleiche IP-Basis für Website und Tracking, bringt diesen Vorteil. Für die meisten Unternehmen, mit denen wir arbeiten, ist Server-Side mit Same Origin das Zielbild. Ob dazu das Google Tag Gateway oder ein eigener Skript-Pfad mit Tag Serving Path kommt, ist dann vor allem eine Frage von Infrastruktur und Kosten. Wer bei Stape hostet, erreicht Same Origin über deren Custom-Loader- und Same-Origin-Optionen, ohne selbst einen Reverse Proxy betreiben zu müssen.
Fragen und Antworten
- Gibt es ein Basis-Setup, mit dem man starten sollte? Zuerst klären, welche Kennzahl am wichtigsten ist. Steht die Analyse im Vordergrund, sollte das Setup die längste Cookie-Laufzeit bieten. Geht es vor allem um Signale für die Werbeplattformen, ist ein Server-Side-Setup die bessere Wahl. Alles Weitere lässt sich später darauf aufbauen.
- Eigene Server oder gemanagter Dienst, etwa für große Shops? Das hängt von der Datenmenge ab. Bis zu einigen Millionen Events ist ein gemanagter Dienst sinnvoll, ebenso wenn Kapazität oder Know-how im eigenen Haus fehlen. Ab einer gewissen Größe zahlt man für den gemanagten Dienst so viel, dass es günstiger wird, Hosting und Wissen ins Haus zu holen, mit allem Wartungsaufwand. Einige Kunden von mohrstade haben diesen Schritt gemacht. Für die meisten Shops empfiehlt Jenny ihn aber nicht.
- Gibt es noch Fälle, in denen reines Client-Side Tracking richtig ist? Für den Einstieg, um überhaupt erste Daten zu haben, ja. Wer aber Vertrauen in die Daten und eine bessere Datenqualität will, kommt laut Jenny für die meisten Fälle um Server-Side nicht herum. Kaum ein Kunde von mohrstade arbeitet heute noch rein clientseitig. Für sie ist das eine Frage der Daten-Reife.
- Welche Kennzahlen sollten die Entscheidung bestimmen? An erster Stelle steht für Jenny das Vertrauen in die Datenqualität. Danach kommt es auf den Schwerpunkt an. Wer vor allem analysieren will, sollte auf die Cookie-Laufzeit optimieren, damit derselbe anonyme Nutzer möglichst lange wiedererkannt wird. Wer vor allem die Kampagnenleistung verbessern will, sollte auf Anreicherung setzen und Signale per API an die Plattformen senden. Die Ladezeit ist das Argument für Web- und Produktteams, die Kosten das für das Finanzteam. Den Schutz vor Werbeblockern hält Jenny für einen netten Zusatz, nicht für das Hauptziel. Lieber habe sie 50 Prozent der Daten in hoher Qualität als 100 Prozent, denen sie weniger vertrauen kann. Server-Side bringt ohnehin nicht 100 Prozent der Daten zurück, sondern nur ein Stück mehr. Wer in das beste Setup investieren will, versucht alle fünf Punkte zu erfüllen, aber das hängt vom Schwerpunkt ab.
- Gibt es die Folien? Jenny teilt ihre Präsentation auf LinkedIn und lädt ausdrücklich dazu ein, sie weiterzugeben. Ihr Ziel: Wer ein Setup oder einen Dienstleister auswählt, soll gut informiert entscheiden.
Session: Warum GA4 nie zu Ihrem CRM passt
Um 14:30 Uhr folgte in Track 1 Josh Silverbauer, Head of Analytics & CRO bei Intrepid Digital. Sein Thema kennt fast jedes B2B-Unternehmen: Im Meeting sagt das Marketing, GA4 zeige 600 Leads im letzten Monat. Der Vertrieb sieht im CRM nur 412. Google Ads meldet wieder eine andere Zahl. Wer hat recht? Laut Josh beide ein bisschen, und beide liegen falsch. Manche Ursachen lassen sich beheben, andere gehören 2026 einfach zur Realität. Josh nennt sechs typische Fehler im Formular-Tracking und zeigt, wie man sie mit Erfolgs-Events im dataLayer und Server-Side GTM behebt.
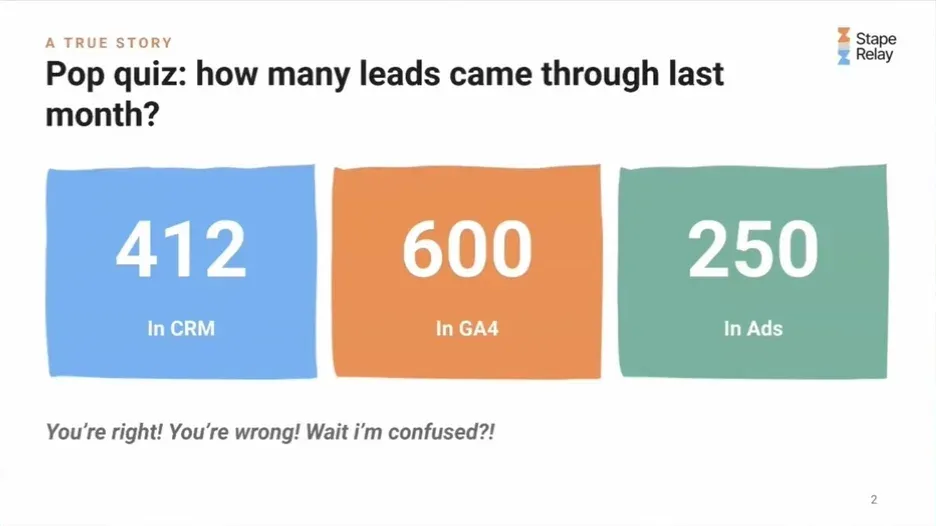
Folie aus dem Vortrag von Josh Silverbauer (Quelle: Intrepid Digital)
Was eigentlich passiert
Die Vorstellung vieler: Ein Nutzer sendet das Formular ab, der GTM bemerkt es, die Conversion wird gezählt. In der Praxis passiert laut Josh meist eines von zwei Dingen:
- Zu wenig gezählt: Das Formular liegt in einem iframe, oder die Danke-Seite ist Teil einer Single-Page-Application. Der Trigger feuert nicht. Das CRM hat einen Lead, GA4 keinen.
- Zu viel gezählt: Jemand nutzt die Suche auf der Website, der GTM hält das für ein Formular, und der Trigger feuert. GA4 meldet plötzlich zehn Leads, dabei hat nur jemand etwas gesucht.
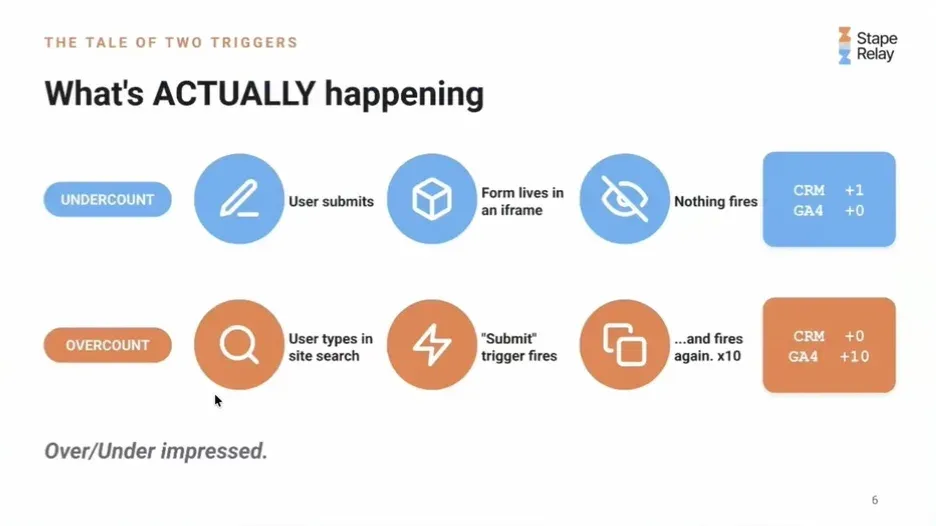
Folie aus dem Vortrag von Josh Silverbauer (Quelle: Intrepid Digital)
Josh nennt sechs Arten, wie der clientseitige Formular-Listener „Sie verrät“. Drei davon haben wir als #GTMfaults-Artikel ausführlich aufbereitet: Formulare im iframe, die Danke-Seite als Conversion und Formular-Trigger vor der Validierung.
Die sechs Fehler im Formular-Tracking
1. Eingebettete Formulare sind eine Blackbox. Formulare aus HubSpot, Marketo, Pardot, Typeform, Calendly oder anderen Buchungs-Widgets liegen oft in einem iframe mit eigener Domain. Der GTM der Website sieht dort nichts. Entweder ist auf der Formular-Domain gar kein GTM eingebunden, oder man muss aufwendig einen Listener bauen, der die Nachricht an die übergeordnete Seite weitergibt. Das CRM bekommt den Lead, GA4 und die Werbeplattformen nicht.
2. Single-Page-Applications vertragen sich schlecht mit dem GTM. Der Trigger „Alle Seiten“ wartet auf einen Seitenaufruf. In einer Single-Page-Application wechselt aber nur eine Komponente, die URL ändert sich nicht oder der Router entfernt Parameter wie ?success=1. Die Danke-Seite löst dann nie eine Conversion aus. Das umgekehrte Problem: Eine klassische Danke-Seite wird mehrfach aufgerufen, per Lesezeichen, durch Neuladen oder weil jemand den Link in Slack teilt. Jeder Aufruf zählt als Lead.
3. Der Trigger feuert vor der Validierung. Wer seine Telefonnummer falsch eingibt und mehrfach auf „Absenden“ klickt, löst jedes Mal ein Formular-Event aus, obwohl das Formular nie erfolgreich abgeschickt wurde.
4. Der Trigger feuert auf den falschen Formularen. Suche, Filialfinder und „Route planen“ sind technisch auch Formulare. Ist der Trigger allgemein auf „Formular gesendet“ eingestellt, zählen sie alle als Lead. Die Kosten pro Lead sehen dann großartig aus, nur die echten Leads fehlen.
5. Dynamisches DOM bricht Trigger. Wer Trigger an CSS-Elemente knüpft, verliert sie, sobald das Marketing ein neues Formular-Design live stellt, oft ohne Bescheid zu sagen. Mehr dazu in unserem #GTMfaults-Artikel zu GTM-Triggern auf CSS-Selektoren.
6. Der Nutzer ist weg, bevor das Tag fertig ist. Ein Conversion-Tag braucht für seine Anfrage einige hundert Millisekunden. Leitet das Formular sofort auf die Danke-Seite weiter, gewinnt die Weiterleitung, und die Anfrage geht verloren.
Dazu kommen Ursachen, die nichts mit dem Formular zu tun haben: Werbeblocker, fehlende Einwilligung, ITP und die Cookie-Begrenzung in Safari, nach der ein Nutzer, der länger nicht zurückkehrt, als neu gilt.
Die Lösung: Erfolgs-Events im Browser, Daten über den Server
Erstens: auf den Erfolg hören, nicht auf den Klick. Die Website sollte ein Event in den dataLayer schreiben, wenn das Formular selbst den Erfolg meldet, also nicht beim Klick und nicht beim Absenden:
window.dataLayer.push({
  event: 'form_success',
  form_id: 'contact_main',
  form_location: 'pricing_page'
});
Das behebt laut Josh in einem Schritt Validierungsfehler, Danke-Seiten in Single-Page-Applications und den Großteil der Probleme mit CSS-Selektoren. Wichtig ist, dass die Daten im dataLayer stehen, bevor das Event ausgelöst wird. Siehe dazu auch unseren Artikel zur Reihenfolge von dataLayer.push.
Für eingebettete Formulare: den Anbieter fragen. Die meisten Anbieter melden einen erfolgreichen Versand per postMessage an die übergeordnete Seite. HubSpot etwa schickt ein message-Event mit hsFormCallback und onFormSubmitted, Calendly ein Event calendly.event_scheduled. Diese Nachrichten fängt man ab und schreibt daraus das Erfolgs-Event in den dataLayer. Die Dokumentation der Anbieter beschreibt das meist.
Zweitens: die Daten über den Server schicken. Entweder vom Web-GTM an den Server-Side GTM, oder direkt aus dem CRM an den Server-Side GTM, der die Daten an alle Werbeplattformen verteilt. Vorher werden sie geprüft, dedupliziert und bereinigt. Warum der Server gewinnt:
- Schlechte Leads: Das CRM hat sie schon aussortiert. Wer aus dem CRM sendet, kann qualifizierte Leads melden, ein viel besseres Optimierungssignal.
- Bots und Duplikate: Die Werbeplattformen sehen sie gar nicht erst. Und wer aus dem Web-GTM sendet, kann anhand der Request-Daten Bots erkennen und aussortieren.
- Werbeblocker und ITP: Es gibt kein Browser-Skript, das blockiert werden könnte. Die Anfrage geht an den eigenen Server.
- Tab während der Weiterleitung geschlossen: egal, die Daten sind schon beim Server.
- Verbindung zum CRM: Qualifizierte Leads, gewonnene Deals und echter Umsatz lassen sich als Conversion melden.
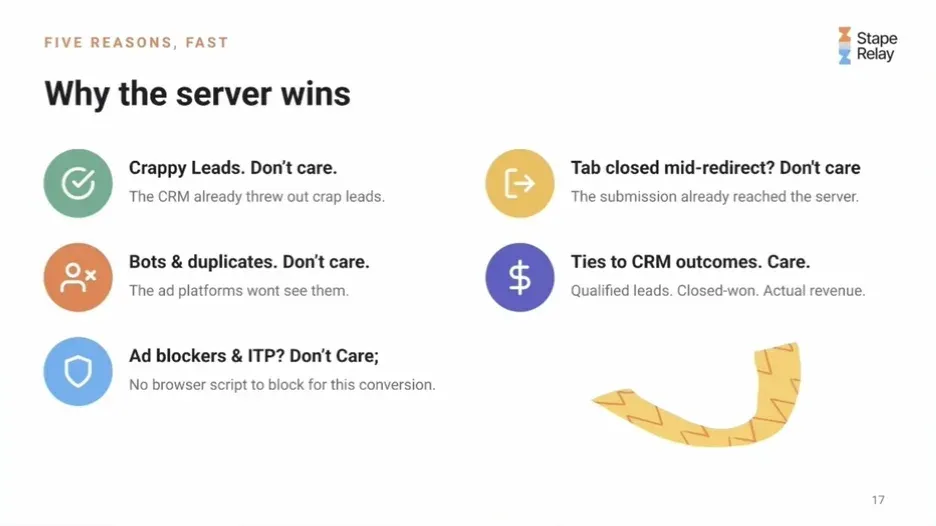
Folie aus dem Vortrag von Josh Silverbauer (Quelle: Intrepid Digital)
Server-Side ist kein Cheat Code. Josh betont drei Grenzen:
- Die Einwilligung gilt weiter. Wer ablehnt, wird nicht getrackt, auch nicht über den Server. Ein Rest an Abweichung zwischen CRM und Marketing-Zahlen bleibt deshalb immer. Consent Mode funktioniert auch mit dem Server-Side GTM und sollte genutzt werden.
- Der Browser bleibt wichtig. Klick-IDs, Cookies und der Sitzungskontext entstehen im Browser. Wer aus dem CRM sendet, muss diese Daten vorher mit dem Lead im CRM speichern.
- Zwei Stape-Power-Ups helfen: Cookie Keeper gegen die Cookie-Begrenzung in Safari und der Custom Loader gegen Blocklisten.
Joshs Fazit: Ein sauberer dataLayer, der beim Erfolg feuert und nicht bei dem, was der GTM für ein Formular hält. Listener für eingebettete Formulare, die den Erfolg an die übergeordnete Seite melden. Und Conversions, die aus dem Browser, dem Backend oder dem CRM über den Server-Side GTM an GA4 und die Werbeplattformen gehen. Seine ausführliche Anleitung dazu hat Josh im Stape-Blog veröffentlicht.
Fragen und Antworten
- Wie bleibt die Attribution erhalten, wenn das Formular von Server zu Server übertragen wird? Möglichst alle Informationen aus dem Browser mitgeben: Klick-IDs, Cookies und, wenn vorhanden und erlaubt, personenbezogene Daten sowie den Consent-Status. Josh legt dafür eigene Cookies im Browser an, befüllt damit beim Absenden versteckte Formularfelder und übergibt so alles an das CRM. Von dort gehen die Daten über den Server-Side GTM oder ein Werkzeug wie Make an die Plattformen. Je mehr Daten, desto besser das Matching.
- Welche Abweichung zwischen den Systemen ist akzeptabel? Josh nennt 10 Prozent als gängigen Richtwert. Darüber ist vermutlich etwas grundlegend falsch, und Entscheidungen werden riskant. Darunter lassen sich die Zahlen zumindest für die Richtung nutzen. Ziel bleibt, die Abweichung so klein wie möglich zu halten. Wie viel eine Abweichung bedeutet, hängt aber auch von der Datenmenge ab. Bei einer kleinen Website mit zehn Besuchern wiegt eine fehlende Conversion schwer, bei Millionen Besuchern kaum.
- Wie erklärt man Abweichungen Stakeholdern ohne technischen Hintergrund? Ohne sie zu belehren, aber klar: Keine Zahl ist die absolute Wahrheit, Attribution ist immer nur eine bestmögliche Annäherung. Josh empfiehlt, früh eine gemeinsame Quelle der Wahrheit festzulegen, etwa das CRM oder ein Dashboard mit dokumentierter Logik. Dazu passende Ziele und Kennzahlen, und dann diese eine Quelle so genau wie möglich machen. So diskutiert niemand mehr über fünf Plattformen mit fünf Zahlen.
- Sollte man Leads über die Data Manager API aus dem CRM in Google Analytics und Google Ads importieren, statt auf Tags zu setzen? Ja, ein Import aus dem CRM sollte dazugehören. Mit Klick-IDs und E-Mail-Adressen ist er genauer und bringt Daten, die der Browser nicht hat. Das Formular-Event im Browser sollte aber bleiben. Es ist das schnellste Signal, dass sich etwas in die richtige Richtung bewegt, und dort entstehen die ursprüngliche E-Mail-Adresse und Telefonnummer. Beides zusammen verbessert das Matching.
Meine Einordnung: Für B2B-Unternehmen ist das die wichtigste Session des Tages. Fast jedes Lead-Gen-Projekt, das wir übernehmen, zeigt mindestens zwei dieser sechs Fehler, meist den allgemeinen Formular-Trigger und die Danke-Seite als Conversion. Der Weg aus Joshs Session ist auch unser Standard: ein Erfolgs-Event im dataLayer, Klick-IDs mit dem Lead im CRM speichern und qualifizierte Leads aus dem CRM über den Server zurück an die Plattformen geben. Und ein Richtwert hilft in jedem Meeting: Bis etwa 10 Prozent Abweichung zwischen GA4 und CRM sind normal.
Session: Mehr aus der Meta Conversions API holen
Um 15 Uhr sprach in Track 1 Katie Glass, Product Marketing Lead bei Meta. Ihr Ausgangspunkt: Gutes Marketing beginnt nicht bei der Technik, sondern beim Unternehmen selbst. Sie wissen, was Ihre Kunden brauchen und was Ihr Unternehmen erreichen will. Daten machen dieses Wissen für Metas Werbesysteme nutzbar. Ihre Formel: Sie liefern den Kontext, Metas KI setzt ihn um. Je klarer und genauer die Daten, desto besser kann das System vorhersagen, wer wahrscheinlich handelt und welche Anzeige passt. Entscheidungen über Strategie, Creatives, Budget und Bewertung bleiben bei Ihnen.
Pixel und Conversions API gehören zusammen
- Das Pixel bleibt das Fundament. Vor einigen Jahren erwarteten viele, dass das Meta-Pixel bald nicht mehr funktioniert. Das ist laut Katie nicht passiert. Es erfasst weiterhin zuverlässig, was Nutzer auf der Website tun, samt Kontext, und ist der einfachste Ort für neue Aktionen.
- Die Conversions API (CAPI) baut darauf auf. Sie sendet Daten direkt vom Server an Meta, damit Verkäufe, Leads und andere Ergebnisse vollständiger und zuverlässiger ankommen. Überschneidende Events aus Browser und Server dedupliziert Meta, sodass jede Aktion nur einmal zählt.
- CAPI ist mehr als ein Web-Produkt. Über passende Integrationen lassen sich auch App-Events, Business Messaging, Offline-Verkäufe und CRM-Daten anbinden. Damit wird die ganze Customer Journey messbar, nicht nur der Teil auf der Website.
Welche Daten sich lohnen
Ein gutes Event beschreibt, was wann passiert ist, bringt Merkmale für den Abgleich mit, etwa Klick-ID oder Kundendaten, und liefert geschäftlichen Kontext, etwa Wert und Währung. Katie empfiehlt, sich zu fragen: Was weiß das Unternehmen nach der ersten Aktion? Wurde der Lead zum Kunden? Fand der Kauf im Laden statt? Wurde das Abo verlängert?
Dabei gilt: Genauigkeit vor Menge. Wer auf Wert optimiert, dessen Gebote richten sich nach den gesendeten Werten. Sind sie falsch oder uneinheitlich, bietet das System falsch. Beispiele für wertvolle Signale sind der korrekte Kaufwert, die spätere Qualität eines Leads und langfristige Werte wie Verlängerungen oder Lifetime Value. Wichtig: Werte zu senden, ändert die Optimierung nicht automatisch. Ziel der Kampagne und Daten müssen zusammenpassen, etwa Lead-Formular-Kampagnen mit CRM-Daten für „Conversion Leads“.
Drei Wege zur Conversions API
| Weg | Aufwand | Kontrolle | Passt für |
|---|---|---|---|
| CAPI Gateway | gering, wenige Klicks bei einem Anbieter wie Stape | gering, nutzt die vorhandenen Pixel-Events | schnellen Einstieg |
| Partner-Lösung über Server-Side GTM, etwa bei Stape | mittel, Partner übernimmt Einrichtung, Updates und Wartung | hoch, eigene Daten, Anreicherung und Umformung möglich | die meisten Unternehmen |
| Direkte Integration | hoch, eigene Entwicklung und Wartung | vollständig | komplexe, stark individuelle Systeme |
Egal welcher Weg: Vier Dinge entscheiden über die Qualität, und jedes davon ist laut Katie ein Eingangswert für das Modell, keine Formalität.
- Abdeckung: Kommen alle wichtigen Aktionen an, im Browser und auf dem Server?
- Abgleich: Lässt sich jedes Event einer Person zuordnen? Ein Event ohne Abgleich nützt wenig.
- Deduplizierung: Browser- und Server-Event derselben Aktion brauchen denselben Event-Namen und dieselbe Event-ID, sonst werden aus einem Verkauf zwei. Beim CAPI Gateway übernimmt Meta das weitgehend, beim GTM und bei direkten Integrationen liegt es bei Ihnen.
- Aktualität: Events sollten möglichst in Echtzeit ankommen, damit das System reagieren kann, solange das Signal nützlich ist.
Die Event Match Quality ist dabei ein wichtiger Indikator, aber keine vollständige Messung. Prüfen Sie Pixel und Server-Verbindung gemeinsam im Events Manager, vor allem nach Änderungen an Website, Tag Manager oder Datenmodell. Denn dann hören funktionierende Setups oft unbemerkt auf zu funktionieren.
Daten mit Sorgfalt: Wissen Sie, welche Events woher kommen und warum sie für Ihre Ziele relevant sind. Respektieren Sie die Entscheidungen Ihrer Kunden und senden Sie keine verbotenen sensiblen Daten, gerade in Branchen wie Gesundheit oder Finanzen. Weder die Übertragung über den Server noch Hashing hebelt diese Regeln aus.
Fragen und Antworten
- Wirken Standard-Events besser als Custom Events? Standard-Events sind am einfachsten einzurichten und Voraussetzung für automatisierte Kampagnen wie Advantage+. Custom Events ergänzen sie, wenn das Geschäftsmodell besondere Schritte hat.
- Was ist der häufigste Fehler bei der Conversions API? Eine zu komplexe Integration im Verhältnis zu den eigenen Ressourcen. Wer direkt selbst integriert, übersieht oft wichtigen Kontext und braucht sehr lange. Katie empfiehlt, mit dem CAPI Gateway oder dem Google Tag Manager zusammen mit einem Partner wie Stape zu beginnen.
- Was bringt das CAPI Gateway? Bei Werbetreibenden, die vorher keine Conversions API hatten, sieht Meta im Schnitt 17,8 Prozent bessere Kosten pro Akquisition, so Katie.
- Welche Event Match Quality ist gut? Über 6,5 sollte sie mindestens liegen, 8 gilt als Goldstandard.
- Beeinflussen andere Events wie „In den Warenkorb“ eine Kampagne, die auf Käufe optimiert? Optimiert wird nur auf das gewählte Ziel. Für die Frage, wem welche Anzeige gezeigt wird, nutzt Meta aber den gesamten Kontext.
- Pixel plus CAPI oder nur CAPI? Immer beides. Das Pixel sammelt im Hintergrund zuverlässig Browserdaten, die CAPI ergänzt geschäftlichen Kontext. Wer nur die CAPI nutzt, verliert oft Metadaten. Wie viel, hängt von der Qualität des CAPI-Setups ab.
- Wie verbessert man die Event Match Quality? Vor allem durch die richtigen Kundenparameter, besonders die Klick-ID. Abdeckung und Aktualität sollte man dabei nicht vergessen.
- Wie prüft man, welches Creative welche Zielgruppe gesehen hat? Nur im Ads Manager in den Kampagnenberichten, nicht über die Conversions API.
- Beziehen sich die Verbesserungen nur auf Metas eigene Zahlen? Die 17,8 Prozent beziehen sich auf die Kosten pro Akquisition. Meta gleicht nach Katies Aussage seine Attribution auch mit ROAS-Kennzahlen und der „Quelle der Wahrheit“ der Werbetreibenden ab.
Meine Einordnung: Katies Vortrag ist eine gute Bestätigung für Server-Side Tracking aus berufenem Mund, mit zwei wichtigen Botschaften. Erstens: Pixel und Conversions API ergänzen sich, das Pixel abzuschalten, kostet Leistung. Zweitens: Genauigkeit schlägt Menge, ein falscher Kaufwert schadet mehr als ein fehlendes Event. In der Praxis sehen wir am häufigsten Probleme bei der Deduplizierung, wenn Browser und Server unterschiedliche Event-IDs senden. Wie Sie das im GTM lösen, steht in unserem #GTMfaults-Artikel zur Event-ID bei Pixel und Conversions API. Das ist genau der Punkt, an dem das CAPI Gateway entlastet und ein GTM-Setup sorgfältig gebaut sein muss.
Abschluss: Was von der Stape Relay 2026 bleibt
Zum Abschluss fassten Dan Murovtsev und Marcin Pluskota den Tag zusammen. Die Neuheiten im Überblick: der bereits veröffentlichte Setup Wizard 2.0, der Enricher 2.0 bis Weihnachten, die Consent Management Platform ab dem 15. November und die Template-Roadmap mit Simo Ahava bis Ende 2026. Alle Teilnehmenden erhalten mit der Mail nach dem Event einen Teilnahmenachweis, eine Umfrage und die Aufzeichnung. Und Stape kündigte mit Josh Silverbauer bereits die nächste Aktion an: einen „Server-Side Santa“ in der Vorweihnachtszeit, Details sollen noch im November folgen.
Mein Fazit des Tages: Die Stape Relay hat gezeigt, wohin sich Server-Side Tracking bewegt. Datenverlust zu verhindern, ist Pflicht und für viele inzwischen gelöst. Jetzt geht es um die Qualität der Signale: Gewinn statt Umsatz, vorhergesagter statt späterer Umsatz, qualifizierte Leads aus dem CRM statt Formular-Klicks, angereicherte Profile statt einzelner Events. Dazu kommen zwei Grundlagen, die oft unterschätzt werden: ein Same-Origin-Setup, ohne das Safari die Cookies weiter begrenzt, und eine saubere Einwilligung, an der auch der beste Server nichts vorbeischleust. Stape baut sein Angebot konsequent in diese Richtung aus, mit eigener CMP, Enricher und Enterprise-Funktionen. Für Unternehmen im deutschsprachigen Raum ist besonders die CMP spannend, sobald sie sich im Alltag bewährt hat.
Resümee: Die fünf wichtigsten Learnings der Stape Relay 2026
- Die Stape-CMP ist der große Wurf, aber kein Selbstläufer. Ab dem 15. November liefert Stape eine eigene Consent Management Platform über die eigene Domain aus, ohne Lizenzgebühr ab dem Pro-Tarif. Wer eine funktionierende CMP hat, sollte sie erst testen. Tracking-Probleme liegen laut Stape selbst meist in der Konfiguration, nicht in der CMP.
- Same Origin entscheidet über die Cookie-Laufzeit. Ein Server-Container auf einer eigenen Subdomain reicht in Safari nicht. Erst wenn Website und Tracking-Server im selben Netz liegen, entfällt die Begrenzung auf 24 Stunden oder sieben Tage.
- Die Qualität der Signale schlägt ihre Menge. Gewinn statt Umsatz, vorhergesagter Umsatz für Leads, qualifizierte Leads aus dem CRM: Wer den Werbeplattformen bessere Werte gibt, bekommt bessere Kampagnen. Aber: Nicht jedes neue Signal ist automatisch besser, testen bleibt Pflicht.
- Formular-Tracking ist die häufigste Fehlerquelle im B2B. Ein Erfolgs-Event im dataLayer statt eines allgemeinen Formular-Triggers und Conversions aus dem CRM über den Server lösen die meisten Abweichungen zwischen GA4 und CRM. Bis etwa 10 Prozent Abweichung sind normal.
- Pixel und Server gehören zusammen. Meta empfiehlt ausdrücklich Pixel plus Conversions API mit sauberer Deduplizierung, und auch Josh und Jenny sehen den Browser weiter als Quelle für Klick-IDs und Kontext.
Die nächste Stape Relay ist bereits angekündigt: Stape verabschiedete sich mit einem „Bis zur Stape Relay 2027“. Die Aufzeichnung der diesjährigen Konferenz erhalten alle Teilnehmenden per Mail, außerdem soll sie auf dem YouTube-Kanal von Stape erscheinen.
Sie möchten wissen, was davon für Ihr Setup sinnvoll ist, etwa der Umstieg auf Same Origin, die Stape-CMP oder sauberes Formular-Tracking mit CRM-Anbindung? Sprechen Sie mich gern an.
Danke an Stape und alle Referenten
Ein großes Dankeschön an das Team von Stape für die Organisation der Stape Relay 2026 und für einen Tag voller Praxiswissen rund um Server-Side Tracking. Mehr zu Stape gibt es auf der Website der Stape Relay und auf LinkedIn.
Danke auch an alle Referentinnen und Referenten, die ihr Wissen geteilt haben:
| Name | Rolle | Website | |
|---|---|---|---|
| Ira Holubovska | COO und Mitgründerin, Stape | stape.io | Profil |
| Denis Golubovskyi | CEO und Mitgründer, Stape | stape.io | Profil |
| Dan Murovtsev | Product Manager, Stape | stape.io | Profil |
| Marcin Pluskota | Community, Stape | stape.io | Profil |
| Giovani Ortolani Barbosa | Integration Engineer, Stape | stape.io | Profil |
| Serge Shkvarnytskyi | Sales & Partnerships Lead, Stape | stape.io | Profil |
| Simo Ahava | Mitgründer, Simmer | teamsimmer.com | Profil |
| Julius Fedorovicius | Gründer und CEO, Analytics Mania | analyticsmania.com | Profil |
| Daniel Perry-Reed | Marketing Measurement & Analytics Consultant, Kickflip Analytics | kickflipanalytics.com | Profil |
| Doug Hall | Technical Director, Duga Digital | dugadigital.com | Profil |
| Juliana Jackson | Director AI Strategy NE, Jellyfish | jellyfish.com | Profil |
| François de Broissia | Data & Analytics Senior Director, Jellyfish | jellyfish.com | Profil |
| Karolina Wrzask | Product Deployment Engineer, Google | google.com | Profil |
| Anastasia Shcherbakova | Lead Product Analyst, Marktplaats | marktplaats.nl | Profil |
| Matteo Zambon | CTO, Tag Manager Italia, und Product Evangelist, Stape | tagmanageritalia.it | Profil |
| Caroline Vidal | Senior MarTech Engineer, Gründerin von Women in Data & Analytics | – | Profil |
| Peter O’Neill | Fractional Digital Analytics Leader, ZHS Orchards | zhsorchards.com | Profil |
| Bhavik Patel | Data Director, Huel | huel.com | Profil |
| Jenny Bachmann | Senior Marketing Technology Consultant, mohrstade | mohrstade.de | Profil |
| Lars Friis | Tracking-Spezialist | – | Profil |
| Josh Silverbauer | Head of Analytics & CRO, Intrepid Digital | gointrepid.com | Profil |
| Katie Glass | Product Marketing Manager, Meta | meta.com | Profil |
| Manisha Mistry | Technical Director, MeasureU | measureu.com | Profil |
Dieser Beitrag ist keine Rechtsberatung. Benjamin Juling ist kein Rechtsexperte für Datenschutz. Wir empfehlen, die Umsetzung vor dem Einsatz mit einem Datenschutz-Experten oder einem Datenschutz-Anwalt zu prüfen.